AI로 장소 검색 서비스 만드는 중입니다 (기술 12) — TypeSafe Jev로 검색 리랭크를 10.3초에서 2.3초로

AI로 장소 검색 서비스 만드는 중입니다 (기술 12) — TypeSafe Jev로 검색 리랭크를 10.3초에서 2.3초로
TypeSafe AI가 2026년 9월 15일에 Jev를 내놨습니다. 텍스트를 쓰지 않고 타입이 정해진 판정과 확률을 바로 내는 모델입니다.
유추카 검색에서 가장 느린 단계가 마침 텍스트가 필요 없는 판정이었습니다. 그 구간만 Jev로 갈아끼우고 일주일간 측정했습니다.
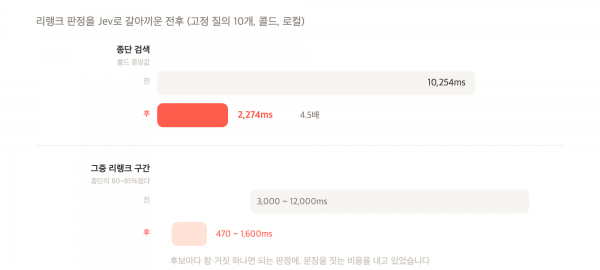
콜드 검색 중앙값이 10.3초에서 2.3초가 됐고, 품질 지표도 같이 올랐으며, 월 비용은 내려갔습니다.
집계 범위는 2026년 9월 17일부터 23일까지, 전부 로컬 측정입니다. 정답셋은 질의 61개·라벨 1,501건이고, 지연은 고정 질의 10개의 콜드 중앙값입니다.
검색 한 번에 무슨 일이 일어나는가
"비 오는 날 혼자 술 한잔" 같은 문장이 들어오면 여섯 단계를 지납니다. 어드민 트레이스 화면이 이 단계 그대로 찍힙니다.
| 단계 | 하는 일 | |
|---|---|---|
| ① | 검색 의도 파악 | 문장을 구조로 — 모드·카테고리·지역·이동시간·속성·정렬 |
| ② | 지역·검색 범위 결정 | 지역명이면 행정구역 전체, 출발지가 있으면 이동시간 반경, 없으면 현재 지도 영역 |
| ③ | 정보 확인 (하드게이트) | "주차 가능" 같은 확인된 사실로 후보를 거른다 |
| ④ | 후보 검색 방식 | 형태소 BM25 + 문서 임베딩 + 청크 임베딩을 섞어 후보 풀을 만든다 |
| ⑤ | 리랭킹 (LLM 재순위·검증) | 후보마다 이 질의에 맞는가를 LLM이 판정하고 순서를 다시 매긴다 |
| ⑥ | 결과 조립 | 정렬·거리·표시 필드를 채워 내보낸다 |
①만 LLM을 한 번 쓰고, ②③④는 색인과 규칙이라 밀리초 단위입니다. ⑥도 마찬가지입니다.
⑤만 성격이 다릅니다. 후보 풀이 60곳이면 판정도 60번입니다.
종단 지연의 80~85%가 한 단계에 있었습니다
운영에서 의도 질의(INTENT) 세 건을 직접 호출해 측정했습니다.
1 210.96초 15.22초 16.67초 └ 이 중 리랭크가 80~85%
로컬에서 고정 질의 10개를 캐시를 비우고 돌리면 콜드 중앙값이 10.25초, p90이 15.8초였습니다. 웜은 0.15초입니다 — 캐시에 있으면 빠릅니다. 처음 들어오는 질의가 느렸습니다.
그 리랭크가 무슨 일을 하는지 다시 보면 이렇습니다.
1 2후보 60곳 각각에 대해 "이 장소가 이 질의에 맞습니까?" → relevant: true | false
답이 참/거짓 하나입니다. 그런데 범용 LLM으로 받으면 이렇게 돌아옵니다.
1{"ranked":[{"idx":0,"relevant":true},{"idx":1,"relevant":false}, …]}
모델이 저 JSON을 토큰 단위로 한 글자씩 씁니다. 자기회귀 디코딩이라 앞 토큰이 나와야 다음 토큰이 나옵니다. 판정 하나에 문장을 짓는 비용을 내고 있었습니다.
기술 9편에서 *"AI 지연은 읽는 시간이 아니라 쓰는 시간이다"*라고 적었습니다. 그때는 출력을 줄였고, 이번에는 쓰지 않게 했습니다.
Jev가 무엇인가
TypeSafe AI가 System One Model이라고 부르는 종류의 첫 모델입니다. 이름은 카너먼의 시스템 1 — 숙고가 아니라 즉각 판단 쪽입니다.
동작이 일반 LLM과 다릅니다.
| 범용 LLM | Jev | |
|---|---|---|
| 출력 | 텍스트를 토큰 단위로 생성 | 타입이 정해진 값 + 보정된 확률 |
| 디코딩 | 자기회귀(앞 토큰 → 다음 토큰) | 비자기회귀 — 한 번에 |
| 요청 형태 | 프롬프트 한 덩어리 | state(맥락) + questions(질문 여러 개) |
| 질문 처리 | 순차 | 한 번의 병렬 패스 |
호출은 POST https://api.typesafe.ai/v1/systemone 하나입니다. 맥락을 state로 주고, 그 맥락에 대한 질문들을 questions로 주면 전부에 대한 답이 한 번에 옵니다.
우리가 쓴 질문 타입은 noul 하나입니다 — 이진 판정을 0~1 확률로 돌려줍니다.
출처 등급을 밝히면, 공식 자료의 *"프런티어 LLM 대비 40~200배 빠르다"*는 벤더 주장입니다. 아래 수치는 전부 저희 워크로드에서 직접 측정한 값이고, 배수가 다릅니다.
어디가 맞고 어디가 안 맞나
여섯 단계 중 Jev를 붙일 수 있는 곳은 한 군데였습니다. 판별 기준은 출력에 문장이 필요한가입니다.
| 단계 | 출력 | Jev |
|---|---|---|
| ① 의도 파악 | 구조화된 JSON(지역·속성·정렬 …) | 값이 열린 필드가 있어 부적합 |
| ③ 하드게이트 | 규칙 | LLM 자체를 안 씀 |
| ④ 후보 검색 | 점수 | LLM 자체를 안 씀 |
| ⑤-a 적합 판정 | true/false |
적합 |
| ⑤-b 추천 이유 생성 | 사람이 읽는 문장 | Jev는 문자열을 못 만든다 — 불가 |
⑤가 두 갈래라는 점이 중요했습니다. 적합 판정과 이유 생성이 이미 다른 배치로 나뉘어 있었습니다. 화면에서 추천 이유는 목록을 펼친 뒤에 필요하므로, 검색 응답과 분리해 비동기로 채우고 있었거든요.
그래서 교체 지점이 코드에 이미 있었습니다. 판정 전용 배치만 Jev로 보내고, 이유 생성은 그대로 뒀습니다.
기존 코드를 안 고치고 붙였습니다
리랭커(IntentRanker)는 손대지 않았습니다. 대신 어댑터를 하나 만들어 형식만 양쪽으로 번역했습니다.
1 2 3 4 5 6 7IntentRanker 가 만드는 JSON {intent, candidates:[{idx,name,…}], 평가기준, 필수속성} ↓ JevVerdictAdapter.toRequest Jev /v1/systemone { state: {...}, questions: { c0:{type:noul}, c1:{…} } } ↓ Jev 응답(후보별 확률) ↓ JevVerdictAdapter.toRanked 임계값으로 가른다 {"ranked":[{"idx":0,"relevant":true}, …]} ← 기존 파서가 읽는 형식
이 설계를 고른 이유가 둘 있습니다.
첫째, A/B가 설정 하나로 끝나야 기여도를 분리해 측정할 수 있습니다. protocol=jev만 켜고 나머지를 그대로 두면, 차이가 나올 때 그게 모델 차이인지 입력 차이인지 헷갈리지 않습니다.
둘째, 입력이 우리가 만든 JSON이라 재파싱이 결정적입니다. 모델 출력을 파싱하는 게 아니라 우리 출력을 다시 읽는 것이라, 여기서 깨질 일이 없습니다.
실패하면 null을 돌려 기존 경로를 그대로 탑니다. 새 의존성이 검색을 끊지 않게요. 그리고 실패를 null 하나로 뭉개지 않고 사유를 남겼습니다. 변환 실패 경로가 여럿이라, 어디서 떨어졌는지 모르면 실패율만 보고 원인을 못 찾습니다.
임계값을 판정 정확도로 고르면 틀립니다
noul이 주는 건 확률입니다. 어디서 적합/부적합을 가를지 정해야 합니다.
판정 단위로 홀드아웃 F1을 측정하면 0.40이 가장 높았습니다. 그런데 그 값으로 종단 정답셋 평가를 돌리면 실패했습니다.
| 임계값 | 홀드아웃 F1 | 종단 eval-gold |
|---|---|---|
| 0.40 | 최고 | FAIL |
| 0.30 | — | FAIL |
| 0.25 | 낮음 | PASS |
이유가 비대칭에 있습니다. relevant=false는 곧 노출 제외입니다. 정답을 떨어뜨리면 사용자가 영영 못 보고, 오답을 들이면 목록 아래쪽에 한 칸 끼는 데 그칩니다. F1은 이 둘을 대칭으로 봅니다.
그래서 임계값은 종단 게이트로만 골랐습니다. 0.25입니다.
같은 이유로 Jev 전용 판정 프롬프트를 따로 만들어 본 것도 기각했습니다. 기존 프롬프트에는 텍스트 생성 모델용 지시가 섞여 있어(JSON 스키마, "모든 후보를 빠짐없이 판정") Jev에는 지킬 필요가 없는 내용이었습니다. 판정 기준만 남겨 다시 썼더니 이렇게 됐습니다.
| 오답노출 | deep recall | |
|---|---|---|
| 기존 프롬프트 | 0.080 | 0.844 |
| Jev 전용 프롬프트 | 0.053 | 0.767 |
오답노출이 34% 줄었는데 deep recall도 같이 떨어졌습니다. 오답만 거른 게 아니라 정답도 걸렀습니다. 임계값을 낮춰 보상해도 되돌아오지 않았습니다.
다수결 투표를 Jev의 확률로 대체했습니다
의도 질의에서는 판정을 세 번 받아 다수결로 정하고 있었습니다. 같은 배치를 LLM에 세 번 보내고, 돌아온 참·거짓 셋을 다수결로 합칩니다. 참·거짓만 던지는 모델은 같은 입력에도 답이 흔들리므로 반복이 분산을 줄여 줍니다.
세 번은 병렬이라 지연은 거의 안 늘었습니다. 늘어난 것은 비용입니다.
Jev는 보정된 확률을 냅니다. 같은 입력에 같은 확률이 나오므로 세 번 받을 이유가 약합니다. 한 번으로 줄여 측정했습니다.
| 콜드 중앙값 | 판정 콜 수 | |
|---|---|---|
| 투표 3회 | 2,534ms | 1× |
| 투표 1회 | 2,274ms | 1/3 |
속도는 소폭인데 판정 호출이 3분의 1이 됩니다. 비용 쪽이 큽니다.
결과
정답셋 61질의로 같은 코드·콜드 캐시에서 기준선과 채택안을 나란히 측정했습니다. 채택 구성은 Jev(임계값 0.25) · 핵심요건 의도의 1차 판정도 Jev로 통일 · 투표 1회입니다.
| 지표 | 기준선(Gemini) | Jev 채택안 | 차이 | 잡음대 |
|---|---|---|---|---|
| deep recall | 0.790 | 0.840 | +0.050 | ±0.003 |
| MRR | 0.685 | 0.708 | +0.023 | ±0.001 |
| R@10 | 0.363 | 0.376 | +0.013 | ±0.006 |
| 오답노출 | 0.103 | 0.089 | −0.014 | ±0.020 |
잡음대는 같은 구성을 반복 측정해 얻은 실측 변동폭입니다. R@10과 오답노출은 1회 측정으로 개선을 주장할 수 없습니다. 잡음대 밖으로 움직인 것은 deep recall과 MRR 둘입니다.
무결성 확인도 함께 남겼습니다 — 결제 오류 0건, 어댑터 경고 0건, 판정 3,417건 전량 jev-latest.
속도와 비용은 이렇습니다.
| 현행 | Jev 채택안 | |
|---|---|---|
| INTENT 콜드 중앙값 | 10,254ms | 2,274ms (4.5배) |
| 리랭크 구간 | 3~12초 | 0.47~1.6초 |
| 월 비용(하루 1,000건) | $580 | $370 |
비용 구조가 특이합니다. 질의 하나당 실측 토큰량이 입력 166,738 · 출력 6,631인데, Jev는 질문 N개에 판정 규칙을 N번 싣는 구조라 입력을 1.76배 더 씁니다.
| 모델 | 입력 $/M | 출력 $/M | 질의당 | 월 |
|---|---|---|---|---|
| Gemini 2.5 Flash-Lite | 0.10 | 0.40 | $0.0193 | $580 |
| Jev | 0.042 | 0 | $0.0123 | $370 |
입력을 두 배 가까이 더 쓰고도 쌉니다. 출력이 무료라서요. 판정처럼 출력이 짧고 입력이 긴 작업에서는 이 구조가 유리한 쪽으로 기울지만, 출력이 긴 작업이면 계산이 달라집니다.
어디에 쓰면 좋고 어디엔 안 맞나
일주일 써 보고 정리한 기준입니다.
맞는 곳 — 출력이 타입으로 닫혀 있고, 같은 맥락에 질문이 여러 개 붙는 작업입니다.
- 후보 적합 판정(이 글의 경우)
- 분류·라우팅·스코어링
- 규칙 위반 여부 확인
안 맞는 곳 — 문자열이 결과물인 작업입니다. 추천 이유 생성, 요약, 번역은 애초에 만들지 못합니다. 값이 열린 필드가 섞인 추출도 반만 덮습니다.
그리고 붙일 때 확인할 것 하나를 덧붙입니다. 임계값은 종단 지표로 고르십시오. 판정 단위 F1이 가장 높은 값과 종단이 가장 좋은 값이 달랐습니다.
운영에 올렸습니다. 기본값은 그대로 두고 환경변수로 켜는 방식입니다 — 되돌릴 때 재배포가 필요 없게요.
위 배수는 전부 로컬 측정입니다. 운영에서 같은 배수가 나오는지는 아직 측정하지 않았습니다. 운영은 네트워크도 부하도 다릅니다. 숫자가 나오면 붙여 적겠습니다.
그럼, 계속.
- 유튜버추천카페로 이동하기
- 실제 장소 소개는 블로그에 올리고 있습니다 — https://blog.naver.com/popitt