
카프카 커넥트와 오프셋 관리(1)
이번 글에서는 먼저 카프카 커넥트에 대해 간략한 소개를 하고, 3.5 버전부터 새롭게 추가된 카프카 커넥트 오프셋 관리 기능에 대해 소개하고자 합니다. 글은 총 2부로 나누어 작성하며, 먼저 1부에서는 카프카 커넥트 소개와 동작 방식에 대해 간략하게 소개하고, 다음으로 이어지는 2부에서 카프카 커넥트 오프셋 관리 기능에 대해 소개하겠습니다.
카프카 커넥트(Kafka Connect)란?
카프카 커넥트는 아파치 카프카(Apache Kafka)와 다른 시스템 간에 데이터를 보내고 받을 수 있는 도구입니다. 소스 시스템에서 카프카로 데이터를 스트리밍 하거나 카프카에서 싱크 시스템으로 데이터를 스트리밍 하는 것에 중점을 두며, 고품질, 안정성, 고성능 등을 제공하여, 사용자 및 관리자가 유연하게 사용할 수 있습니다.
뿐만 아니라, REST API를 제공하여 별도의 코드 작성 없이 사용자가 원하는 커넥터를 생성, 삭제 등을 할 수 있는 장점도 가지고 있습니다.
카프카 커넥트 역할
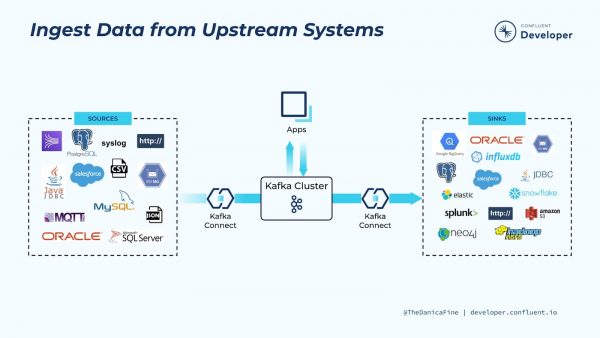
위 그림(출처: 컨플루언트)은 카프카와 카프카 커넥트 및 데이터 시스템들의 관계를 나타낸 그림입니다. 좌측에 위치한 데이터 시스템들을 소스(source)라고 하고, 우측의 시스템들을 싱크(sink)라고 자주 표현합니다.
그림의 내용을 조금 더 자세히 설명하자면, 소스 시스템의 데이터를 카프카 커넥트를 통해 카프카로 전송하고, 카프카에 저장된 데이터는 카프카 커넥트를 통해 싱크 시스템으로 전송합니다. 카프카를 중심으로 두고, 양 종단의 외부 시스템 사이에서 카프카 커넥트가 데이터 전송 처리하는 역할을 담당합니다. 대략적인 카프카 커넥트의 역할에 대해 이해가 되셨나요? 다음에서 설명할 카프카 커넥트의 동작으로 넘어가기 전에 커넥트 관련 용어에 대해 간단히 정리하겠습니다.
카프카 커넥트 기본 용어
카프카 커넥트에서 사용되는 몇 가지 용어들이 있는데, 이 부분은 커넥트를 이해하는데 필요한 부분이므로 숙지한다면, 커넥트를 이해하는데 도움 됩니다.
- 커넥터(connector): 외부 시스템과 카프카 커넥트 런타임 간의 인터페이스 역할, 태스크들을 관리하며, 소스 커넥터와 싱크 커넥터로 구분
- 태스크(task): 실제 카프카와 시스템 사이에서 데이터를 가져오거나 보내는 작업을 처리
- 워커(worker): 커넥터 및 태스크를 실행하는 프로세스
- 컨버터(converter): 커넥터와 데이터를 보내거나 받는 시스템 간의 데이터 포맷 간에 레코드를 시리얼라이즈 또는 디시리얼라이즈 처리
- 트랜스폼(transform): 레코드를 보내거나 받을 때 레코드를 간단한 로직으로 변환
카프카 커넥트의 동작
앞에서 본 그림과 같이 데이터를 가지고 있는 소스 시스템이 매우 다양합니다. 커넥트가 이렇게 다양한 시스템들을 다루기 위해서는 다양한 종류의 커넥터(connector)들이 존재합니다. 대표적인 커넥터를 소개하자면, JDBC 커넥터, HDFS 커넥터, ES 커넥터, S3 커넥터 등이 있습니다. 그 외 다양한 커넥터들도 있는데, 커넥터들은 Confluent Hub에서 확인할 수 있습니다.
그리고, 이러한 커넥터들은 크게 소스 커넥터와 싱크 커넥터로 분류합니다. 소스 시스템과 가깝게 위치한 커넥터를 소스 커넥터, 싱크 시스템과 가깝게 위치한 커넥터를 싱크 커넥터라고 합니다.
커넥트 관련 용어들이 언급되기 시작하면서, 커넥트를 이해하기 다소 어려울 수 있는데 그림과 함께 예제를 통해 알아보겠습니다.
현재 현업에서 데이터베이스에서 지속적으로 발생하는 데이터를 HDFS로 보내야 하는 상황이라고 가정하겠습니다. 해당 작업은 한 번에 완료할 수도 있겠지만, 여기서는 크게 총 두 단계로 나누어 진행하겠습니다.
첫 번째 단계에서는 소스 데이터베이스에서 카프카로 전송, 두 번째 단계에서는 카프카에서 HDFS로 전송합니다.
먼저 첫 번째 단계입니다. 일반적인 상황이라면, 데이터베이스 시스템에 연결하고 데이터를 가져온 후 카프카로 전송하는 애플리케이션을 직접 개발해야 합니다. 물론 상황에 따라 또는 개인에 따라 직접 개발하는 것이 편할 수도 있습니다. 하지만, 때로는 빠르고 간단하게 파이프라인만 생성하고 싶은 경우도 있을 수 있습니다. 후자의 경우 카프카 커넥트를 이용한다면, JDBC 커넥터를 이용해 손쉽게 문제를 해결할 수 있습니다.
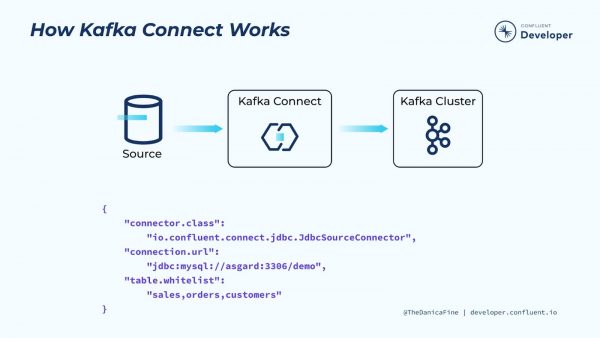
JDBC 커넥터를 이용하는 경우 위 그림과 같이 JDBC 커넥터에서 요구하는 몇 가지 값들(클래스, 커넥션 정보, 테이블등)만 추가하고 REST API를 호출하면, 즉시 JDBC 커넥터가 생성됩니다. 다음으로 데이터 베이스에서 발생하는 데이터가 카프카의 토픽으로 전송되게 됩니다. 한 가지만 추가로 설명하자면, 커넥터 내부에는 실제 데이터 처리를 담당하는 태스크(task)가 실행되고, 커넥터는 이러한 태스크들을 관리합니다. 또한 커넥터의 task.max 옵션을 통해 실행하고자 하는 태스크의 수를 지정할 수 있습니다.
이렇게 사용자는 한 줄의 코드 작성이 없이, REST API 호출만으로 데이터베이스에서 발생하는 데이터를 카프카로 전송할 수 있습니다. 바로 이렇게 간단하게 파이프라인을 생성할 수 있다는 부분이 카프카 커넥트의 장점입니다. 이로써, 첫 번째 단계가 완료되었습니다.
다음으로 두 번째 단계인 카프카에서 HDFS로 전송하는 과정을 살펴보겠습니다. 앞서 첫 번째 단계와 마찬가지로 카프카 -> HDFS로의 데이터 전송작업 역시 카프카 커넥터를 사용하며, 이번에는 HDFS 커넥터를 이용합니다. HDFS 커넥터에서 요구하는 몇 가지 값들만 추가한 후 REST API를 호출하면 즉시 HDFS 커넥터가 생성되고, 카프카에 저장된 데이터를 HDFS로 전송하게 됩니다. 앞선 JDBC 커넥터와 마찬가지로 코드 작성 없이 또 하나의 파이프라인이 생성되었습니다.
전체적인 동작 내용을 정리해 보면 다음 그림과 같습니다.
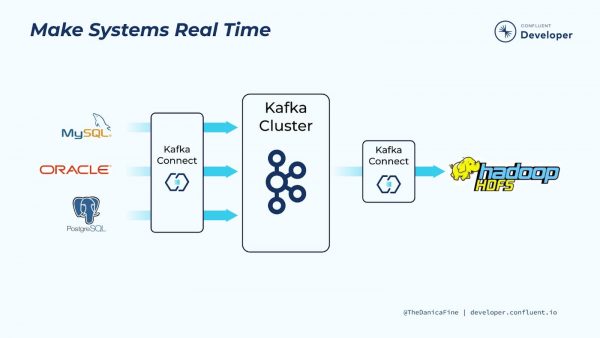
데이터의 흐름 순서대로 살펴보면, 데이터베이스(소스 시스템) -> JDBC 소스 커넥터(카프카 커넥트) -> 카프카 -> HDFS 싱크 커넥터(카프카 커넥트) -> HDFS(싱크 시스템) 순으로 데이터가 처리됩니다.
또한 별도의 코드 작성 없이, 카프카 커넥트의 JDBC 커넥터와 HDFS 커넥터만 이용하여 전체적인 데이터 파이프라인이 구성되었습니다. 예제에서 설명한 바와 같이 카프카 커넥트를 이용하면, 다양한 소스 또는 싱크 시스템들과 카프카 사이의 데이터 파이프라인을 손쉽게 구성할 수 있습니다.
만약 소스 커넥터, 싱크 커넥터 개념이 잘 이해가 안 된다고 하시면, 너무 어렵게 생각하지 마시고 소스 커넥터 = 프로듀서, 싱크 커넥터 = 컨슈머라고 생각하셔도 무방합니다. 오히려 이렇게 생각하시는 게 더 편할 수도 있습니다.
정리
지금까지 카프카 커넥트에 대한 기본적인 내용에 대해 설명하였습니다. 카프카 커넥트는 이 외에도 분산 모드에서 사용할 수 있도록 내결함성, 스케일 아웃, 컨버터, 트랜스폼을 이용한 데이터 처리 등 다양한 기능들을 가지고 있습니다. 해당 내용들을 이 글에서 모두 다루기에는 부족하오니, 실전 카프카 개발부터 운영까지의 11장 카프카 커넥트 내용을 참고하시면 좋을 것 같습니다. 다음 글에서는 제가 설명하고자 하는 카프카 커넥트 오프셋 관리 기능에 대해 설명하겠습니다. 지금까지 긴 글 읽어주셔서 감사합니다.



