PostgreSQL 9.6 Parallel Query & FDW

0. 과연 잘 될까?!
최근에 PostgreSQL 9.6 가 2016 년 9월 29일 Release 되었습니다. ( 최신버전 PostgreSQL 9.6.1 2016-10-27 ) PostgerSQL 9.6 new features 중에서 Parallel Query 와 FDW ( Foreign Data Wrappers ) 이 가장 주목할 만합니다. FDW는 다른 데이터베이스 서버(Orcale 또는 다른 PostgreSQL 서버)의 데이터를 조회할 수 있는 기능입니다.
http://www.postgresql.org/docs/current/static/release-9-6.html
Major Features: Postgres 9.6
http://momjian.us/main/writings/pgsql/features.pdf
What's New in PostgreSQL 9.6
http://wiki.postgresql.org/wiki/NewIn96#Parallel_Query
http://wiki.postgresql.org/wiki/NewIn96#postgres_fdw
Sharding with postgres_fdw
http://snowman.net/slides/pgfdw_sharding.pdf
흔히 말하는 대용량 데이터베이스 ( Very Larage Database or HIgh Volume Database ) 는 2가지의 필요조건을 충족해야 합니다. 바로 Parallel Query 와 Database Partition 입니다. 그리고, 이 단계를 넘어서 필요한 필요조건은 Cluster or MPP ( Massively Parallel Processing ) Database 입니다. Cluster Database 의 대표적인 예는 Oracle RAC ( Real Application Cluster) 이고, MPP Database 의 대표적인 예는 Pivtoal Greenplum 입니다. ( Pivotal Greenplum 은 PostgreSQL 기반입니다. )
Parallel Query 와 FDW 가 제대로만?! 동작해준다면 유사 MPP Database 처럼 사용할 수도 있을 것 같습니다. ( 실제로 PostgeSQL-XL 란 Scalable Open Source PostgreSQL-based Database Cluster 란 오픈소스 프로젝트가 있습니다. )
Scalable Open Source PostgreSQL-based Database Cluster
http://www.postgres-xl.org
How will Postgres-XL exploit the Parallel Query Capabilities of PostgreSQL 9.6?
http://blog.2ndquadrant.com/how-will-postgres-xl-exploit-the-parallel-query-capabilities-of-postgresql-9-6
PostgreSQL FDW 에서 Parallel Query 동작할지는 미지수이지만, 구글링을 통해서 찾아본 봐로는 몇년전 발표자료들에서는 된다는 것 같습니다. 그래서, 한번 테스트를 해보았습니다. 추가적으로 MySQL FDW 도 해보았습니다.
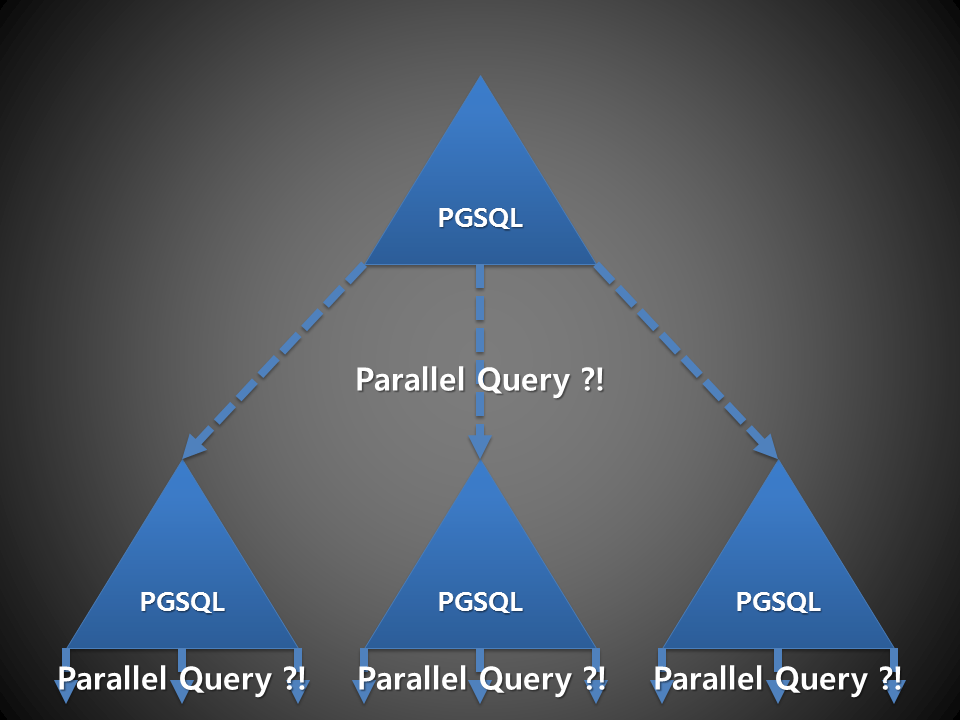
이 블로그에서는 PostgreSQL 9.6 Parallel Query ( local ) 성능에 대해서는 논하지 않습니다. 2ndQuadrant blog 를 통해서도, 제가 간단하게 테스트를 해보아도 parallel factor (worker) 가 4 이상일 경우의 성능은 크게 의미가 없습니다. Adam's law 에 너무너무 충실하다고 할까요?! 향후에 조금 더 성능개선이 되리라 봅니다. ( EDB 를 믿습니다. )
PostgreSQL 9.6: Parallel Sequential Scan
http://blog.2ndquadrant.com/postgresql96-parallel-sequential-scan
| Workers | Time |
| 0 | 24767.848 ms |
| 1 | 14855.961 ms |
| 2 | 10415.661 ms |
| 3 | 8041.187 ms |
| 4 | 8090.855 ms |
| 5 | 8082.937 ms |
| 6 | 8061.939 ms |
준비물 :
PostgreSQL 9.6.1
http://yum.postgresql.org/repopackages.php
MySQL 5.6.34 ( MySQL Sandbox 지원때문에 MySQL 5.7 안씀!! )
http://dev.mysql.com/downloads/mysql/5.6.html#downloads
MySQL SandBox
http://mysqlsandbox.net
1. PostgreSQL 9.6 Parallel Query + FDW ( postgres_fdw )
결론부터 말씀드리면... 안됩니다. ㅠㅠ
Foreign Data Wrappers and You with Postgres
http://www.slideshare.net/EnterpriseDB/foreign-data-wrappers-and-you-with-postgres
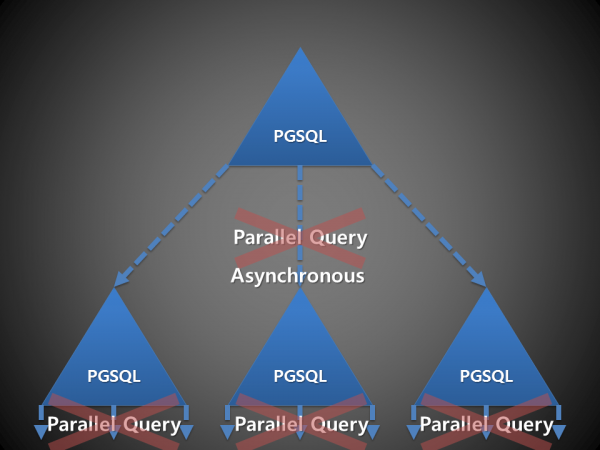
FDW ( Foreign Data Wrappers ) 는 Parallel Query 보다는 Asynchronous Query 입니다. PostgreSQL 9.5 보다는 개선되었기 때문에 나름 의미는 있겠지만, 결국은 Parallel Query 와는 무관하게 Async 하게 동작하는 하는 겁니다. 그리고, 각 remote postgres 에서 Parallel Query 로 실행되지 않습니다. ㅠㅠ
그래도, 결과적으로는 비슷합니다?! 개별 remote table access cost 를 1 이라고 하면, non-async 하다면 2 node access cost 가 1 + 1 입니다. 그러나, 실제 cost 는 1.5 ~ 1.8 정도의 cost 만 소요합니다. async 하니까?! 그렇지만, 결국 remote postgres 에서 Parallel Query 가 동작하지 않기 때문에 개이득은 적습니다.
Parallel Query != Async Query
slide 17/22 - " Can use libpq’s asynchronous API to issue multiple pending queries "
http://momjian.us/main/writings/pgsql/sharding.pdf
| PostgreSQL Parallel Query (local) | -> | postgres_fdw | -> | PostgreSQL Parallel Query (remote) |
| (libpq's async API) | -> | PostgreSQL Parallel Query (remote) |
Parallel Query Parameters
Compared to the 9.5 release, new parameters have been introduced inside the configuration file. These are:
- max_parallel_workers_per_gather: the number of workers that can assist a sequential scan of a table;
- min_parallel_relation_size: the minimum size that a relation must have for the planner to consider the use of additional workers;
- parallel_setup_cost: the planner parameter that estimates the cost of instantiate a worker;
- parallel_tuple_cost: the planner parameter that estimates the cost of transferring a tuple from one worker to another;
- force_parallel_mode: parameter useful for testing, strong parallelism and also a query in which the planner would operate in other ways.
-- default 0
SET max_parallel_workers_per_gather TO 8;
-- default 8MB
--SET min_parallel_relation_size TO DEFAULT;

-- default 1000
--SET parallel_setup_cost TO DEFAULT;
-- default 0.1
SET parallel_tuple_cost TO DEFAULT;

-- default 0
SET parallel_setup_cost to 1;
Generate Data ( local, remote )
-- Local Postgres
DROP TABLE local_tbl;
CREATE TABLE local_tbl (c01 INTEGER PRIMARY KEY, c02 CHAR(1000));
INSERT INTO local_tbl VALUES (generate_series(1, 1000000), 'aaaaa');
ANALYSE local_tbl;

-- Remote Postgres 01
DROP TABLE local_tbl;
CREATE TABLE local_tbl (c01 INTEGER PRIMARY KEY, c02 CHAR(1000));
INSERT INTO local_tbl VALUES (generate_series(1, 1000000), 'aaaaa');
ANALYSE local_tbl;

-- Remote Postgres 02
DROP TABLE local_tbl;
CREATE TABLE local_tbl (c01 INTEGER PRIMARY KEY, c02 CHAR(1000));
INSERT INTO local_tbl VALUES (generate_series(1000001, 2000000), 'aaaaa');
ANALYSE local_tbl;
Create Server, Foreign Table ( postgres_fdw )
DROP EXTENSION postgres_fdw CASCADE;
CREATE EXTENSION postgres_fdw;

-- Remote Postgres 01
CREATE SERVER pg_fdw_server_01
FOREIGN DATA WRAPPER postgres_fdw
OPTIONS (host '127.0.0.1', port '5433', dbname 'test');

CREATE USER MAPPING FOR pgsql
SERVER pg_fdw_server_01
OPTIONS (user 'pgsql', password 'pgsql');

-- remote table 에는 PK 가 반드시 있어야 하지만,
-- local table 은 PK 가 반드시 없어야 합니다.
CREATE FOREIGN TABLE remote_tbl_01
(
   c01 INTEGER,
   c02 VARCHAR(1000)
)
SERVER pg_fdw_server_01
OPTIONS (table_name 'local_tbl');

-- Foreign Table 은 Analyze 되지 않습니다.
ANALYZE remote_tbl_01;

-- Remote Postgres 02
CREATE SERVER pg_fdw_server_02
FOREIGN DATA WRAPPER postgres_fdw
OPTIONS (host '127.0.0.1', port '5434', dbname 'test');

CREATE USER MAPPING FOR pgsql
SERVER pg_fdw_server_02
OPTIONS (user 'pgsql', password 'pgsql');

CREATE FOREIGN TABLE remote_tbl_02
(
 c01 INTEGER,
 c02 VARCHAR(1000)
)
SERVER pg_fdw_server_02
OPTIONS (table_name 'local_tbl');

ANALYZE remote_tbl_02;
Explain Plan Query
\timing on
\pset pager off

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM local_tbl;

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_01;
EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_02;

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_01
UNION ALL
SELECT AVG(C01) FROM remote_tbl_02;

-- default 0.1
SET parallel_tuple_cost TO 0;
-- default 1000
--SET parallel_setup_cost TO DEFAULT;
-- default 0
SET max_parallel_workers_per_gather TO 8;
-- default 8MB
--SET min_parallel_relation_size TO 1;
-- default 0
SET parallel_setup_cost to 1;

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM local_tbl;

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_01;
EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_02;

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_01
UNION ALL
SELECT AVG(C01) FROM remote_tbl_02;
2. PostgreSQL 9.6 Parallel Query + FDW ( mysql_fdw )
MySQL 도 해보았습니다. 잘 동작합니다. Local Table 에는 Parallel Query 가 적용되기 때문에 이 부분을 잘 이용하면 MySQL Spider Engine, Presto 등과 또 다른 구성과 운영이 가능히리라 봅니다. 물론 추천하지 않습니다?! ㅠㅠ
PostgreSQL foreign data wrapper for MySQL
http://github.com/EnterpriseDB/mysql_fdw
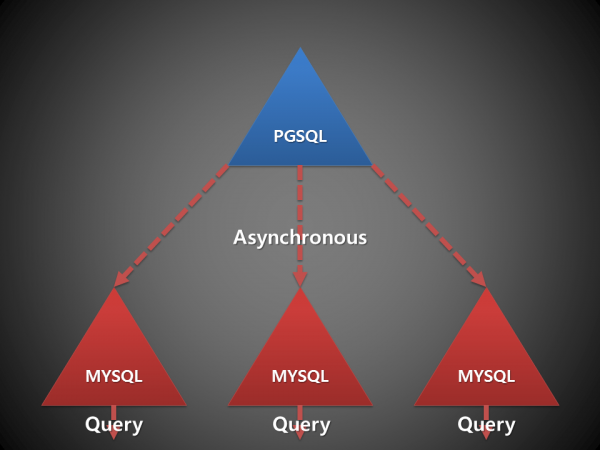
| PostgreSQL Parallel Query (local) | -> | mysql_fdw | -> | PostgreSQL Parallel Query (remote) |
| -> | PostgreSQL Parallel Query (remote) |
Create Server, Foreign Table ( mysql_fdw )
DROP EXTENSION mysql_fdw CASCADE;
CREATE EXTENSION mysql_fdw;

-- Remote MySQL 01
CREATE SERVER my_fdw_server_01
FOREIGN DATA WRAPPER mysql_fdw
OPTIONS (host '127.0.0.1', port '16035');

CREATE USER MAPPING FOR pgsql
SERVER my_fdw_server_01
OPTIONS (username 'root', password 'msandbox');

-- remote table 에는 PK 가 반드시 있어야 하지만,
-- local table 은 PK 가 반드시 없어야 합니다.
CREATE FOREIGN TABLE remote_tbl_01
(
 c01 INTEGER,
 c02 VARCHAR(1000)
)
SERVER my_fdw_server_01
OPTIONS (dbname 'test', table_name 'tbl');

-- Foreign Table 은 Analyze 되지 않습니다.
ANALYZE remote_tbl_01;

-- Remote MySQL 02
CREATE SERVER my_fdw_server_02
FOREIGN DATA WRAPPER mysql_fdw
OPTIONS (host '127.0.0.1', port '16036');

CREATE USER MAPPING FOR pgsql
SERVER my_fdw_server_02
OPTIONS (username 'root', password 'msandbox');

CREATE FOREIGN TABLE remote_tbl_02
(
 c01 INTEGER,
 c02 VARCHAR(1000)
)
SERVER my_fdw_server_02
OPTIONS (dbname 'test', table_name 'tbl');

ANALYZE remote_tbl_02;
Explain Plan Query
\timing on
\pset pager off

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM local_tbl;

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_01;
EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_02;

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_01
UNION ALL
SELECT AVG(C01) FROM remote_tbl_02;

-- default 0.1
SET parallel_tuple_cost TO 0;
-- default 1000
--SET parallel_setup_cost TO DEFAULT;
-- default 0
SET max_parallel_workers_per_gather TO 8;
-- default 8MB
--SET min_parallel_relation_size TO 1;
-- default 0
SET parallel_setup_cost to 1;

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM local_tbl;

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_01;
EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_02;

EXPLAIN (ANALYZE ON, VERBOSE OFF, COSTS OFF, BUFFERS ON)
SELECT AVG(C01) FROM remote_tbl_01
UNION ALL
SELECT AVG(C01) FROM remote_tbl_02;
3. 결론
PostgreSQL 9.6.1 Parallel Query + FDW 는 되지 않습니다. remote postgres 에서도 Parallel Query 가 되지 않습니다.