
Spring Batch CSV Reader & Writer
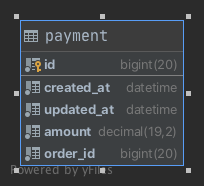
Spring Batch를 이용해서 데이터베이스에 저장되어 있는 정보를 CSV file로 저장을 하는 방법에 대해서 작성해보겠습니다.
CSV Writer
데이터 흐름
payment

csv

데이터의 흐름은 간단합니다. payment table -> payment.csv으로 변경됩니다. payment table의 불필요한 칼럼 id, created_ay, updated_at은 빼고 amount, order_id만 CSV에 저장하겠습니다.
Batch Code
@Configuration
class CsvWriterJobConfiguration(
    private val jobBuilderFactory: JobBuilderFactory,
    private val jobDataSetUpListener: JobDataSetUpListener,
    entityManagerFactory: EntityManagerFactory
) {
    private val CHUNK_SIZE = 10

    @Bean
    fun csvWriterJob(
        csvWriterStep: Step
    ): Job =
        jobBuilderFactory["csvWriterJob"]
            .incrementer(RunIdIncrementer())
            .listener(jobDataSetUpListener)
            .start(csvWriterStep)
            .build()

    @Bean
    @JobScope
    fun csvWriterStep(
        stepBuilderFactory: StepBuilderFactory
    ): Step =
        stepBuilderFactory["csvWriterStep"]
            .chunk<Payment, PaymentCsv>(CHUNK_SIZE)
            .reader(reader)
            .writer(writer)
            .build()

    private val reader: JpaPagingItemReader<Payment> =
        JpaPagingItemReaderBuilder<Payment>()
            .queryString("SELECT p FROM Payment p")
            .entityManagerFactory(entityManagerFactory)
            .name("readerPayment")
            .build()

    private val writer: FlatFileItemWriter<PaymentCsv> =
        FlatFileItemWriterBuilder<PaymentCsv>()
            .name("writerPayment")
            .resource(FileSystemResource("src/main/resources/payment.csv"))
            .append(true)
            .lineAggregator(PaymentCsvMapper().delimitedLineAggregator())
            .headerCallback {
                it.write(PaymentCsvMapper().headerNames.joinToString(","))
            }
            .encoding(StandardCharsets.UTF_8.name())
            .build()
}

data class PaymentCsv(
    val amount: BigDecimal,
    val orderId: Long
)

class PaymentCsvMapper :
    CsvLineAggregator<PaymentCsv> {
    override val headerNames: Array<String> = arrayOf(
        "amount", "orderId"
    )
}
Job
@Bean
fun csvWriterJob(
    csvWriterStep: Step
): Job =
    jobBuilderFactory["csvWriterJob"]
        .incrementer(RunIdIncrementer()) // (1)
        .listener(jobDataSetUpListener) // (2)
        .start(csvWriterStep) // (3)
        .build()
- (1): 동일한 job parameter으로 여러 번 job을 실행시켜도 문제없게
run.id를 증가시킵니다. - (2):
beforeJobpayment 100 rows를 insert 합니다. - (3):
csvWriterStep해당 step을 실생 시킵니다.
Step
@Bean
@JobScope
fun csvWriterStep(
    stepBuilderFactory: StepBuilderFactory
): Step =
    stepBuilderFactory["csvWriterStep"]
        .chunk<Payment, PaymentCsv>(CHUNK_SIZE) // (1)
        .reader(reader) // (2)
        .writer(writer) // (3)
        .build()

private val reader: JpaPagingItemReader<Payment> =
    JpaPagingItemReaderBuilder<Payment>()
        .queryString("SELECT p FROM Payment p")
        .entityManagerFactory(entityManagerFactory)
        .name("readerPayment")
        .build()
- (1): chunk size 및, inout, output 클래스 지정합니다.
- (2):
readerPayment는 전체를 조회합니다. (chuk size 별로 limit ?, ? query가 발생합니다. 한 번에 모두 가져오는 구조는 아닙니다.) - (3):
writerPaymentFlatFileItemWriterBuilder 기반으로 Writer을 진행할 CSV에 대한 정보를 생성합니다.
writerPayment
private val writer: FlatFileItemWriter<PaymentCsv> =
    FlatFileItemWriterBuilder<PaymentCsv>()
        .name("writerPayment")
        .resource(FileSystemResource("src/main/resources/payment.csv")) // (1)
        .append(true) // (2)
        .lineAggregator(PaymentCsvMapper().delimitedLineAggregator()) // (3)
        .headerCallback { // (4)
            it.write(PaymentCsvMapper().headerNames.joinToString(","))
        }
        .encoding(StandardCharsets.UTF_8.name())
        .build()


interface CsvLineAggregator<T> {
    val headerNames: Array<String>

    fun delimitedLineAggregator(
        delimiter: String = ","
    ) =
        object : DelimitedLineAggregator<T>() {
            init {
                setDelimiter(delimiter) // 3-1
                setFieldExtractor(
                    object : BeanWrapperFieldExtractor<T>() {
                        init {
                            setNames(headerNames) // // 3-2
                        }
                    }
                )
            }
        }
- (1):
output을 사용할Resource을 지정합니다. - (2):
ture을 지정하면 해당 경로에 이미 파일이 있으면 파일을 추가합니다. - (3): csv 파일에 집계할 방식에 대해서 작성합니다.
CsvLineAggregator인터페이스를 기준으로 진행됩니다. csv 필드에 대한 구분은,을 사용하며,PaymentCsvMapper기반으로 필드 순서가 결정됩니다. - (4): csv 파일에 header 정보를 입력합니다.
PaymentCsvMapper에 headNames를 사용해서 (3)에서 사용한 필드 순서와 동일하게 지정합니다.
CsvLineAggregator, PaymentCsvMapper를 사용하지 않아도 문제는 없지만 Srping Batch에서 지원하는 lineAggregator, headerCallback 사용법을 단순화 시켰습니다. 프레임 워크에서는 상대적으로 저수준의 기능을 제공해주기 때문에 각 서비스에서 고수준으로 변경해서 사용하는 방법을 고려해서 개발하는 것도 개발자에게 중요한 스킬이라고 생각합니다.
실행 결과
java -jar build/libs/study-0.0.1-SNAPSHOT.jar --job.name=csvWriterJob
해당 테스트는 docker-compose.yaml 기반 mysql 5.7 기반으로 동작 됩니다.
amount,orderId
1.00,1
2.00,2
3.00,3
4.00,4
5.00,5
6.00,6
7.00,7
8.00,8
9.00,9
10.00,10
11.00,11
12.00,12
13.00,13
14.00,14
15.00,15
16.00,16
17.00,17
18.00,18
19.00,19
20.00,20
21.00,21
...
amount, orderId header 정보 및 데이터가 정상적으로 저장돼있는 것을 확인할 수 있습니다.
IntelliJ Plugins


IntelliJ 사용한다면 위 두 개의 CSV 플러그인을 추천드립니다.
CSV Reader
Spring Batch를 이용해서 CSV 파일을 읽어 데이터베이스에 저장하는 방법에 대해서 작성해보겠습니다.
데이터 흐름
amount,orderId
1.00,1
2.00,2
3.00,3
4.00,4
5.00,5
6.00,6
7.00,7
8.00,8
9.00,9
10.00,10
11.00,11
12.00,12
13.00,13
14.00,14
15.00,15
16.00,16
17.00,17
위 CSV 파일을 읽어 데이터베이스에 저장합니다.
Batch Code
@Configuration
class CsvReaderJobConfiguration(
    private val jobBuilderFactory: JobBuilderFactory,
    private val stepBuilderFactory: StepBuilderFactory,
    entityManagerFactory: EntityManagerFactory
) {
    private val CHUNK_SIZE = 10

    @Bean
    fun csvReaderJob(
        csvReaderStep: Step
    ): Job = jobBuilderFactory["csvReaderJob"]
        .incrementer(RunIdIncrementer()) // (1)
        .listener(JobReportListener()) // (2)
        .start(csvReaderStep)
        .build()

    @Bean
    @JobScope
    fun csvReaderStep(): Step =
        stepBuilderFactory["csvReaderStep"]
            .chunk<PaymentCsv, Payment>(CHUNK_SIZE) // (3)
            .reader(reader) // (4)
            .processor(processor) // (5)
            .writer(writer) // (6)
            .build()

    private val processor: ItemProcessor<in PaymentCsv, out Payment> =
        ItemProcessor {
            it.toEntity()
        }

    private val reader: FlatFileItemReader<PaymentCsv> =
        FlatFileItemReaderBuilder<PaymentCsv>()
            .name("paymentCsv")
            .resource(ClassPathResource("/payment.csv")) // (7)
            .linesToSkip(1) // (8)
            .delimited()
            .delimiter(DelimitedLineTokenizer.DELIMITER_COMMA) // (9)
            .names("amount", "orderId") // (10)
            .fieldSetMapper { // 11
                PaymentCsv(
                    amount = it.readBigDecimal("amount"),
                    orderId = it.readLong("orderId")
                )
            }
            .build()

    // (12)
    private val writer: JpaItemWriter<Payment> =
        JpaItemWriterBuilder<Payment>()
            .entityManagerFactory(entityManagerFactory)
            .build()
}
Job
- (1): 동일한 job parameter으로 여러 번 job을 실행시켜도 문제없게
run.id를 증가시킵니다. - (3):
csvReaderStep해당 step을 실생 시킵니다.
Step
- (3): chunk size 및, inout, output 클래스 지정합니다.
- (4):
readerPaymentCSV 파일을 라인별로 읽습니다. - (5):
processor읽은 CSV 파일을 Entity POJO 객체를 생성해서 넘겨줍니다. - (6):
writerJpaItemWriterBuilder를 이용해서 Enttiy를 데이터베이스에 저장합니다. - (7):
ClassPathResource를 이용해서 해당 CSV 파일의 리소스를 지정합니다. classpath 기준으로resources/payment.csv에 위치한 파일을 읽습니다. - (8):
linesToSkip(1)첫 번째 라인은 header로 해당 데이터를 skip 합니다. - (9):
DelimitedLineTokenizer.DELIMITER_COMMA은 문자열","으로 CSV 파일에 대한 구분자 값 문자열을 지정합니다. - (10): CSV 파일에 필드명을 지정합니다.
- (11): CSV의 DTO객체인
PaymentCsv에 어떻게 바인딩 시킬지 지정합니다. - (12):
entityManagerFactory기반으로 해당 엔티티를 영속화 합니다.
결과
$ ./gradlew bootJar
$ java -jar build/libs/study-0.0.1-SNAPSHOT.jar --job.name=csvReaderJob

해당 데이터가 모두 저장되이 었는것을 확인 할 수 있습니다.



