JPA 엔터티 카운트 성능 개선하기
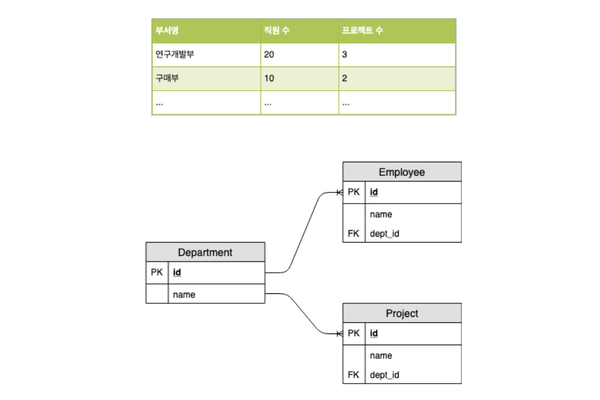
JPAJava Persistence API로 애그리게잇을 구현할 때면 흔히 루트 엔터티(전역 식별성을 지니며 주체로 쓰이는 엔터티)에 연관 엔터티 컬렉션을 매핑한다. 때때로 루트 엔터티는 연관 엔터티 컬렉션의 카운트를 제공해야 하는 경우가 있는데 여기서 성능 문제가 발생할 수 있다. 이 글은 연관 엔터티 컬렉션의 카운트를 구할 때 발생할 수 있는 성능 문제를
 Pop your eXperience. Share It.
JPAJava Persistence API로 애그리게잇을 구현할 때면 흔히 루트 엔터티(전역 식별성을 지니며 주체로 쓰이는 엔터티)에 연관 엔터티 컬렉션을 매핑한다. 때때로 루트 엔터티는 연관 엔터티 컬렉션의 카운트를 제공해야 하는 경우가 있는데 여기서 성능 문제가 발생할 수 있다. 이 글은 연관 엔터티 컬렉션의 카운트를 구할 때 발생할 수 있는 성능 문제를
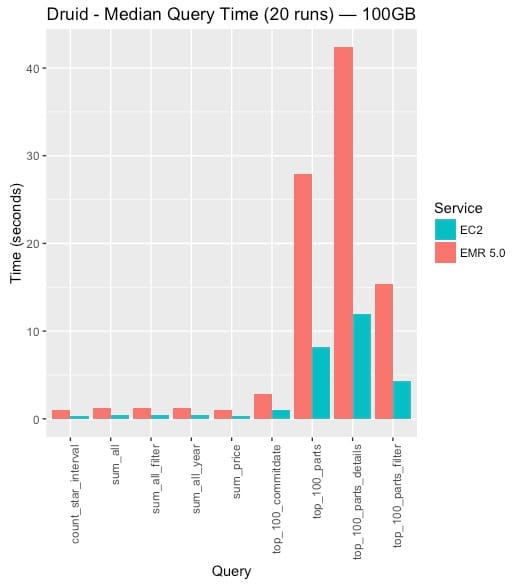
들어가면서.. Druid는 Timeseries 데이터를 자체에 내장된 Lambda architecture 구조를 기반으로 데이터의 eventually exactly-once delivery를 보장하는 시스템입니다. 또한 데이터 적재시에 지정한 단위 시간 기준의 rollup(pre-aggregation)을 통한 데이터 축약과 column기반의 dictionary 인코딩 및 bitmap 자료구조로 복수개의 임의의 조합으로 구성된 column들에 대한 aggregation 질의에 대하여 sub-second수준으로 응답할 수
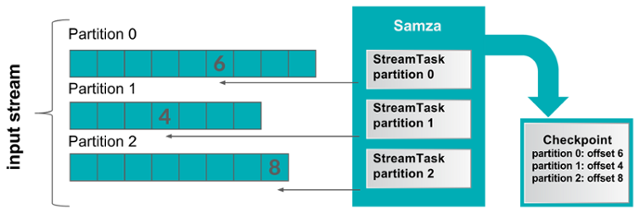
이전글 : 아파치-실시간-처리-프레임워크-비교분석 (1) 지난 글 에서는 아파치 프로젝트로 오픈되어 많은 인기를 얻고있는 Storm, Trident, Spark, Samza, Flink 에 대한 기본 특성과 분산 플랫폼의 필수 이론을 살펴보았습니다. 이번 글 에서는 무정지형(Fault Tolerance) 시스템구축, 상태관리, 성능 등의 좀더 깊이있는 주제와 더불어 실시간 스트리밍 처리 플랫폼에 대한 가이드라인