이직에 대한 단상
최근 지인이 이직을 준비하고 계시면서 회사 선택에 대해 많은 고민을 하고 계신 것을 보았습니다. 그 분에게 간단하게 제가 선택했던 방법에 대해 간단하게 알려 주었습니다. 그 분도 제 방법을 따라했는지는 모르겠지만 글로 공유해보는 것도 좋겠다는 생각이 들었습니다. 이직은 인생에서 아주 중요한 결정입니다.이 글은 지극히 개인적인 의견이며이직 관련해서는 회사의 문화, 규모
 Pop your eXperience. Share It.

최근 지인이 이직을 준비하고 계시면서 회사 선택에 대해 많은 고민을 하고 계신 것을 보았습니다. 그 분에게 간단하게 제가 선택했던 방법에 대해 간단하게 알려 주었습니다. 그 분도 제 방법을 따라했는지는 모르겠지만 글로 공유해보는 것도 좋겠다는 생각이 들었습니다. 이직은 인생에서 아주 중요한 결정입니다.이 글은 지극히 개인적인 의견이며이직 관련해서는 회사의 문화, 규모
Bigdata 시스템을 구축한 대부분의 회사나 조직에서는 Hadoop 중 파일 시스템에 해당하는 HDFS(Hadoop Distributed File System) 를 기본 데이터 저장소로 활용하고 있습니다. HDFS는 Bigdata 시스템의 가장 기초부분이라고 할 수 있습니다. 이런 시스템이 장애라도 발생하면 모든 분석 업무가 중단될 가능성이 많습니다. HDFS에 저장된 데이터의 규모도 엄청 크기 때문에 HDFS 클러스터 자체를
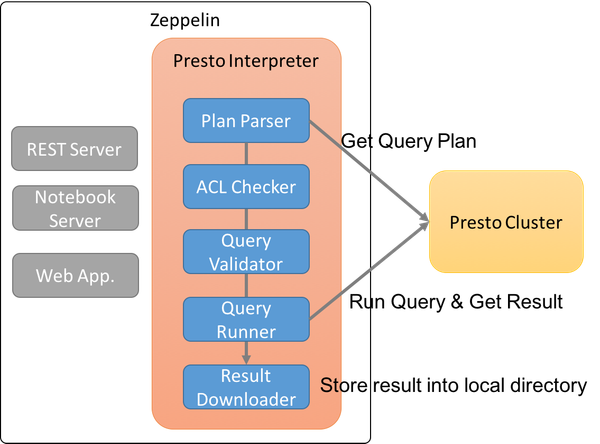
이번 글은 "Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(1)" 에 대한 세부 기술적인 내용에 대한 글입니다. 지난 글에서는 사용자들의 요청사항을 기반으로 Presto, Zeppelin을 이용하여 대용량 데이터를 분석할 때 사용자가 직접 SQL을 사용할 수 있는 시스템을 만든 이유와 솔루션 선정에 대해 설명하였습니다. 첫번째 글와 이번 글은 다음
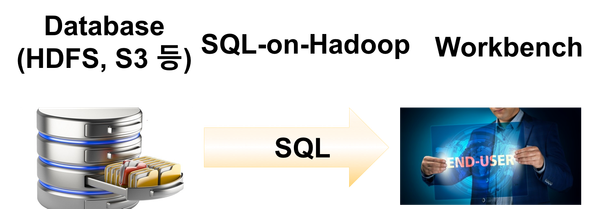
최근 데이터 저장, 처리 관련 다양한 솔루션과 오픈 소스가 나타나면서 다양한 모습으로 데이터 처리 시스템을 구축할 수 있게 되었다. 이번 글에서는 6개월 정도 작업을 통해 현재 운영 중인 서비스에 적용한 Presto, Zeppelin를 이용하여 간단한 BI 체계를 구축했던 경험에 대해 공유하고자 한다. 이 글은 두 개의 글로 구성되어 있으며 첫 번째
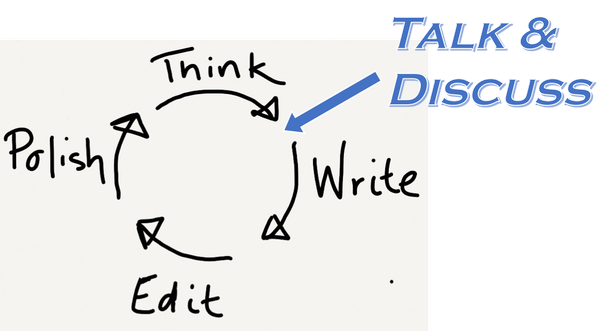
최근에 들어 실력과 경험은 많지만 자신의 실력을 오로지 자신의 운영하는 서비스나 회사에만 불사르고 계신 개발자 분들에게 경험, 기술을 공유해보라고 설파하고 있습니다. 넘사벽 수준으로 글을 잘 쓰시는 개발자 분들도 많이 있지만 반대로 자신의 지식, 경험을 글로 표현하는데 어려움을 겪고 있는 개발자 분들 많이 있습니다. 스스로 평가해보면저도 그렇게 글을 잘 쓰는 편은
이번 글에서는 Java8 Stream의 parallel에 대해 살펴보도록 하겠습니다. Stream API는 설계 시 실제 실행에 대한 부분을 추상화 시켜 각 Element에 대한 처리가 어떻게 실행되는지에 대해서는 프로그래머는 신경쓰지 않이도 된다. 즉, 병렬 처리 등도 쉽게 할 수 있게 설계되어 있다. 하지만 쉽다는 의미는 좋다, 효과적이다 라고 할 수 없기 때문에 Stream에서
Java8에서는 Lambda와 Stream이라는 새로운 개념을 통해 기존 Java를 이용하는 프로그램 방식과는 완전 다른 형태의 프로그램을 가능하도록 하고 있습니다. 필자도 최근 Presto의 소스 코드를 보면서 이제부터 만드는 코드는 Java8 스타일로 개발을 해야 겠다고 생각하고 몇가지 프로그램을 만들어 보고 있습니다. Java8 스타일로 프로그램을 만드는 중에 첫번째 부딪힌 문제가 for loop에서의 break 문제
오늘 지인이 질문때문에 HBase의 HTable 클래스의 puts와 batch에 대해 코드를 잠깐 살펴 보았습니다. At a glance로 본거라서 틀린 부분이 있을 수 있습니다. 틀린 부분이 있으면 알려주시면 수정하겠습니다. puts와 batch는 처리 성능을 높이기 위해 여러개의 row를 모아서 한번에 보내는 방식으로 구현되어 있습니다. 내부적으로는 파라미터로 받은 Row 목록에서 rowkey를 이용하여 같은 regionserver에서