ai
AI로 장소 검색 서비스 만드는 중입니다 (기술 9) — 속도 최적화 상세: 어디가 진짜 병목이었나
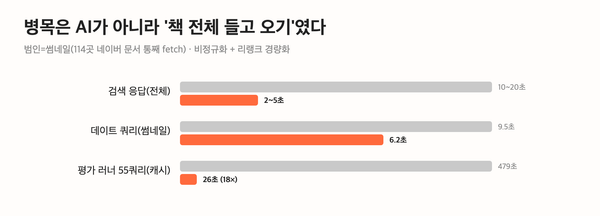
6편에서 "10초 걸리던 검색을 1초로"를 이야기했습니다. 이번 글은 그 뒤의 정확한 숫자와 방법입니다. 그리고 이 글의 진짜 주제는 속도가 아니라 "내가 느리다고 생각한 곳은 대체로 느린 곳이 아니었다" 입니다. 원칙 하나: 추측하지 말고 측정하라. 이 글에 나오는 네 번의 최적화 중 세 번은 제가 처음에
 Pop your eXperience. Share It.

ai
6편에서 "10초 걸리던 검색을 1초로"를 이야기했습니다. 이번 글은 그 뒤의 정확한 숫자와 방법입니다. 그리고 이 글의 진짜 주제는 속도가 아니라 "내가 느리다고 생각한 곳은 대체로 느린 곳이 아니었다" 입니다. 원칙 하나: 추측하지 말고 측정하라. 이 글에 나오는 네 번의 최적화 중 세 번은 제가 처음에
ai
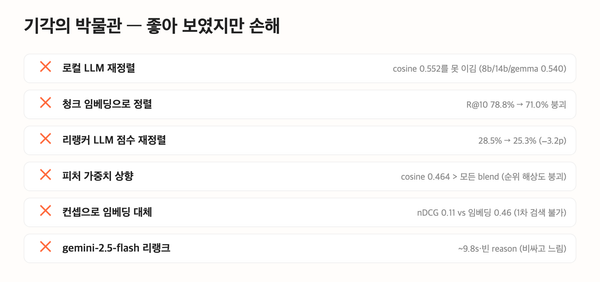
이 연재의 숨은 주제는 "직관은 자주 틀린다" 였습니다. 기술 7편의 평가 인프라가 걸러낸 실패들을 한자리에 모았습니다. 그냥 나열하지 않고 왜 그렇게 믿었는지까지 적었습니다 — 실패의 값어치는 결과가 아니라 어디서 논리가 꺾였는지에 있으니까요. 들어가며 — 기각을 기록해야 하는 이유 성공한 개선은 코드에 남습니다. 코드를 보면 뭘 했는지 알 수 있죠. 그런데
ai
이 연재에는 "좋아 보였지만 재보니 손해였다"가 계속 나옵니다. 로컬 리랭커, 청크 정렬, LLM 재정렬… 그런데 그걸 무엇으로 판정했을까요? 이번 글은 그 자(尺) 이야기입니다. 그리고 그 자가 흔들려서 아무것도 못 재던 시절과, 자를 고정하다 발견한 정답셋 자체의 오류들을 함께 다룹니다. "결과 괜찮은데?"는 측정이 아니다
ai
기술 4편의 하드게이트도, 5편의 청크도 각 장소에 라벨이 붙어 있어야 작동합니다. 그런데 라벨은 누가 붙일까요. 장소는 6천 곳이 넘고 매일 늘어납니다. 이번 글은 그 라벨을 사람 없이 채우는 데이터 공장 이야기 — 그리고 LLM이 자꾸 없는 바다를 만들어내던 사건 — 입니다. 라벨이 없으면 게이트도 없다 기술 4편에서 "한옥 카페"는
ai
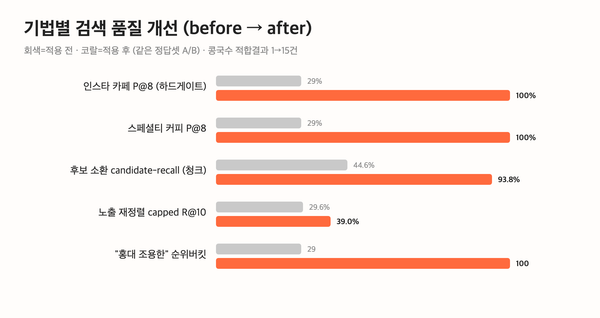
기술 4편은 "하드게이트는 정밀도엔 강하지만, 라벨과 후보가 적으면 재현율이 희생된다"로 끝났습니다. 이번 글은 그 후보를 더 많이·정확히 불러오는 이야기입니다. 그리고 중간에 "개선이 아니라 개악"이라는 측정 결과가 나와 폐기 직전까지 갔던 반전이 있습니다. 수치는 유추카 자체 오프라인/종단 평가 실측입니다. 리뷰 30개를 벡터 하나로
ai
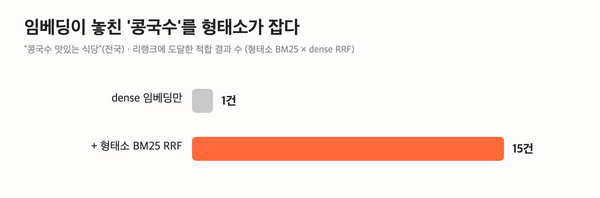
기술 3편에서 "임베딩은 뜻은 잡지만 정확한 단어는 못 잡는다"를 봤습니다. 이번엔 한 걸음 더 들어갑니다 — 단어가 맞아도 여전히 틀리는 경우, 그리고 그걸 막기 위해 '비슷함'을 아예 '조건'으로 고정한 이야기입니다. 수치는 유추카 자체 A/B(사람 라벨 정답셋) 실측입니다. 감자탕집을 찾았는데 한옥
ai
3편에서 "임베딩 튜닝이 멋져 보였지만 실패했다"고 했습니다. 이번 글은 그 임베딩의 구체적 약점과, 그걸 형태소 색인(BM25)과 융합(RRF) 으로 메운 이야기입니다. 검색 품질편의 첫 번째입니다. 수치는 유추카 자체 실측(2026-06~07). 리랭크 적합 건수는 라이브 트레이스 기준입니다. 그 전에 — 임베딩이 대체 뭔가 이 글
ai
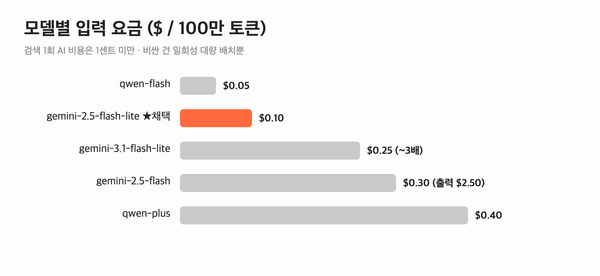
기술 1편은 "로컬 LLM은 벽에 부딪혔고, 클라우드로 가되 기능마다 다른 모델을 쓰기로 했다"로 끝났습니다. 이번 글은 그 라우팅의 근거가 된 실제 숫자입니다. 그리고 여기엔 처음에 제가 갖고 있던 두 가지 착각이 나옵니다 — "AI 서비스는 부를 때마다 돈이 나간다" 와 "상위 티어 모델이 더 낫다&
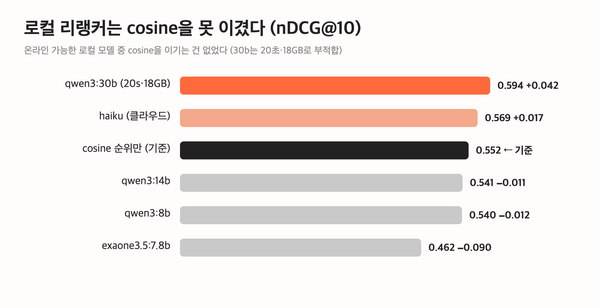
연재 본편이 "삽질기"라면, 이제부터 이어지는 기술편 10편은 그 뒤에서 돌린 A/B와 평가의 실제 숫자입니다. 본편 4편에서 "메모리가 터졌다"고만 하고 넘어갔는데, 이번 글은 그 장비의 정확한 스펙과, 로컬 모델이 정확히 어디서·왜 무너졌는지를 숫자로 남깁니다. 그리고 이 글에는 예상 못 한 결말이 하나 있습니다.
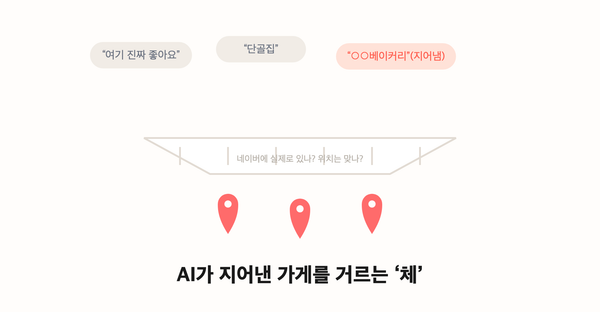
AI로 장소 검색 서비스 만드는 중입니다 (2) — 영상에서 '장소'를 캐내는 법 지난 편에서 "유튜버가 다녀온 곳을 자동으로 모으겠다"고 호기롭게 말했습니다. 그 첫 번째 벽이 바로 이거였어요. 자막엔 가게 이름이 없습니다. 생각해 보면 당연합니다. 카페 영상에서 사람은 "여기 진짜 분위기 좋죠? 디저트도 꼭 드셔보세요&
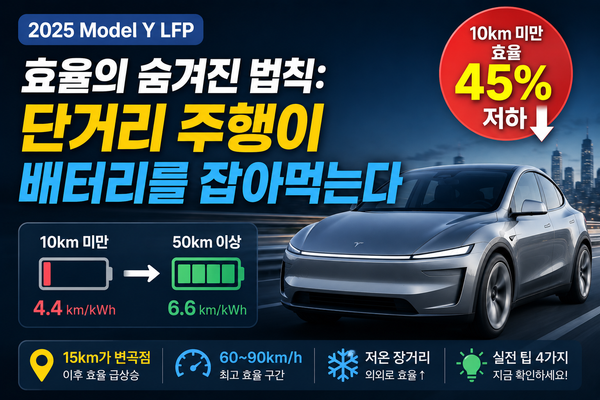
Tesla Model Y RWD 효율의 숨겨진 법칙: 단거리 주행이 배터리를 잡아먹는다 > 분석앱: POPSLA 한줄 요약 2025년식 Model Y 주니퍼(LFP 62kWh)의 실제 주행 데이터 66회 분석 결과, 단거리(10km 미만) 주행의 효율은 장거리(50km 이상) 대비 45% 저하되는 것으로 나타났습니다. 10km 미만 단거리 32회 주행에서 이론상 21.2kWh면
다시 글쓰기를 새로 시작해보려고 합니다. 잘 정리된 글보다는 개발 중에서 발생하는 이슈 기술적인 이슈 처리 위주로 숏하게 써보려고 합니다. 안하는 것보다는 조금이라도 하는게 좋다라는 생각으로 진행합니다. Spark에서 기존 잘 실행되고 있는 프로그램을 복사해서 몇가지 수정한 후 실행 시 다음과 같은 에러가 발생 하였습니다. "Text data source supports only a