김형준

김형준
Spring Boot와 AngualrJS를 조합한 코드 자동 생성 도구(scaffolding)

Spring Boot와 AngualrJS를 조합한 코드 자동 생성 도구(scaffolding)

필자는 Spring을 제대로 사용해 본적은 없습니다. 한두번 프로젝트 등에서 사용해본적은 있지만 대부분 전체 기능 중의 일부만을 사용하는 정도라고 할 수 있습니다. 그래서 Spring 자체에 대한 이해도가 높지는 않습니다. 과거의 경험을 보면 Spring은 초기 프로젝트 구성하는데 손이 많이 가거나, Spring을 잘 사용하는 아키텍트가 프로젝트 구성을 해줘야 잘 사용할 수 있었던 프레임워크라는
By 김형준
오픈소스 git 프로젝트에 Pull Request 보내기

오픈소스 git 프로젝트에 Pull Request 보내기

리눅스를 개발한 리누스 토발스가 만든 소스 코드 형상관리 도구인 git이 인기를 끌면서 많은 오픈소스 프로젝트가 git을 이용하고 있습니다. git 의 인기에는 git 이 제공하는 개념과 컨셉이 기존 형상관리 도구보다 뛰어나기도 하지만 git 레포지토리를 클라우드로 서비스하고 있는 github.com의 존재도 큰 영향을 했습니다. 최근에는 오픈소스 프로젝트 뿐만 아니라 많은 기업들이 github.

By 김형준

Rails CarrierWave로 저장된 파일 다른 객체로 복사하기

제가 Rails에 대한 블로그 글을 쓰는 날이 드디어 왔군요. 일단 간단한 Tip 입니다. Rails로 첨부파일을 저장할 경우 CarrierWave를 많이 사용합니다. CarrierWave를 사용하게 되면 로컬 저장소 뿐만 아니라 S3 저장소와도 쉽게 연동이 되며 이미지 파일의 경우 thumbnail 이나 해상도별로 여러 버전을 쉽게 만들 수 있습니다. 다음 예제와 같이 특정 모델에 저장된

By 김형준
YARN 무엇에 쓰는 물건인고?

YARN 무엇에 쓰는 물건인고?

Hadoop은 크게 두가지 컴포넌트로 구성되는데 하나는 파일을 저장할 수 있는 분산 파일 시스템인 HDFS(Hadoop Distributed File System)과 분산 컴퓨팅 환경을 제공하는 YARN(Yet Another Resource Negotiator) 입니다. Hadoop 을 처음 접하시는 분들은 HDFS에 대해서는 쉽게 이해하지만 YARN에 대해서는 개념을 잡기 어려워하시는 분들이 있습니다. 그 이유는 Hadoop하면 MapReduce를 많이

By 김형준
Presto 사용자 정의 함수 만들기

Presto 사용자 정의 함수 만들기

Presto는 SQL on Hadoop 계열의 오픈소스 솔루션으로 Facebook 에서 개발하였으며, 현재 Netflix 등에서 사용되고 있는 솔루션입니다. 분산된 서버에서 실행되며 SQL 처리 중 발생하는 중간 데이터는 메모리 기반으로 처리함으로써 기존 Hive on MR 보다 아주 빠른 성능으로 SQL을 처리할 수 있습니다. 또한 다양한 스토리지에 저장된 데이터를 SQL을 이용하여 Join 할 수

By 김형준
Standby NameNode 실행하기

Standby NameNode 실행하기

Hadoop에서 이중화 구성으로 운영하는 도중 Standby NameNode 등에 문제가 발생하여 새로운 서버로 교체해야 하거나, 디스크를 아예 교체해야 하는 상황이 발생할 수 있습니다.  Hadoop NameNode 이중화 구성 시 장애에 대한 내용은 다음글 참고하세요. * Hadoop NameNode 이중화 시 fencing의 역할 이렇게 새로운 하드웨어 또는 디스크에 Standby NameNode를 다음과 같은 명령으로 실행하면 예외가

By 김형준
코딩 인터뷰 꼭 해야 하나?

코딩 인터뷰 꼭 해야 하나?

아재 연배가 되다 보니 의도하지 않게 최근 몇년 동안은 채용을 위해 개발자의 면접관으로 참석하는 일이 많아 지고 있습니다.  면접관마다 지원자를 보는 관점과 방식은 다르겠지만 이 글에서는 제가 개발자 인터뷰를 진행할 때 주로 묻는 질문과 어떤 관점을 중점적으로 보는지 정리해보려고 합니다. 최근 제 지인분들도 인터뷰를 많이 다니고 계신데 한군데 오래 계신

By 김형준
Kafka Python client 성능 테스트

Kafka Python client 성능 테스트

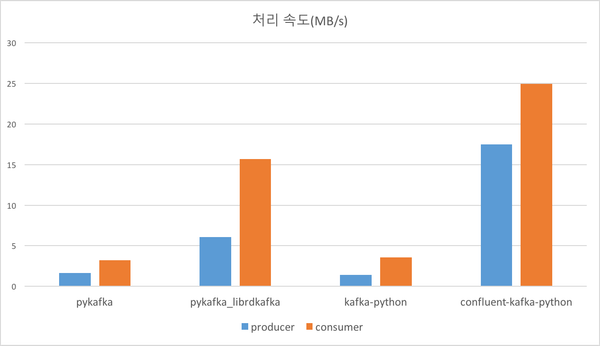
Kafka는 최근 비동기 시스템 구축이나 대용량 데이터 수집을 위해 반드시 필요한 시스템이 되었다. Python은 빅데이터 처리를 위해 많이 사용되는 언어이기 때문에 Kafka의 데이터를 처리하기 위해 Kafka Python 클라이언트도 많이 사용한다. 다음 기사는 여러 종류의 Kafka Python client 성능 테스트에 대한 결과이다. Python 사용자라면 결과에 관심을 가져볼만 하다. http://activisiongamescience.github.

By 김형준
오픈소스: 코드 분석 어떻게 하나?

오픈소스: 코드 분석 어떻게 하나?

MySQL, Apache, Tomcat 등과 같은 오픈 소스는 매뉴얼이나 문서, 책 등도 많이 나와 있으며 오픈 소스이지만 솔루션 자체도 안정적이라서 특별한 이유가 아니면 소스를 분석할 필요는 없습니다. 하지만 Hadoop이나  HBase  등과 같은 솔루션은 문서도 부족하지만 문서로만 설명할 수 없는 복잡한 내용으로 구성되어 있는 솔루션이 많습니다. 따라서 제대로 솔루션을 사용하거나 운영하기 위해서는

By 김형준
Presto Kafka connector 개선 실패기

Presto Kafka connector 개선 실패기

이 글은 Presto 관련해서 계속 연재되는 글 중 하나입니다. 이전글을 못보신 분들은 다음 글을 참고하세요. Presto SQL을 이용하여 Kafka topic 데이터 조회하기 Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(1) Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(2)   다 읽고 실망하실 분들을 위해 미리 밝히지만 이글은 실패한 삽질기

By 김형준

Presto SQL을 이용하여 Kafka topic 데이터 조회하기

Presto는 다양한 저장소를 지원하고 있는데 데이터 수집을 위해 Queue로 많이 사용되고 있는 Kafka도 기본적으로 제공하고 있습니다. 즉, Kafka의 topic에 저장된 데이터를 Presto SQL을 이용하여 조회할 수 있으며 Hadoop, S3, MySQL 등에 저장된 테이블과 Join 연산도 가능하다는 의미입니다. Presto와 Kafka를 연결하려는 이유는 저희 로그 데이터는 S3에 저장되는데 S3의 경우 Block Storage가

By 김형준