jerryjung

jerry jerry gogo

[TIP] 개발자는 막일 하는 사람이 아닙니다. 막일을 줄이기 위한 유용한 팁 1

[TIP] 개발자는 막일 하는 사람이 아닙니다. 막일을 줄이기 위한 유용한 팁 1

매일매일 짜는 스크립트는 이제 그만 NO PAINS, NO GAINS 고급진 개발자가 갖춰야 할 덕목(?) 중 하나는 좋은 툴을 발견하여 반복적이고 시간을 까먹는 작업을 효율화 하거나 필요시에는 툴을 직접 개발 하는 일이다.  필자의 경우 구현한 실시간 처리 시스템의 성능 테스트(throughput) 측정을 위해 반복적으로 가짜 데이터를 생성 해야 했다. 나름 자동화
By jerryjung
Time series OLAP – Glue Architecture(5)

Time series OLAP – Glue Architecture(5)

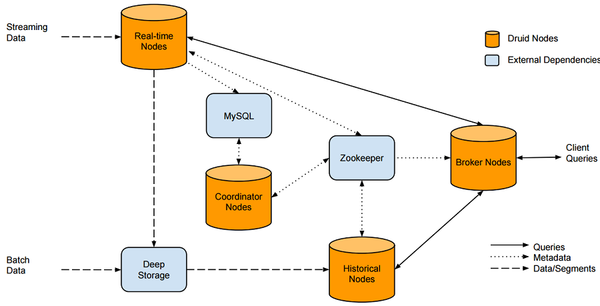
Druid - 어벤저스 계획을 세우지 못하는 것은 실패를 계획하는 것이다 - 에피존스 람다 아키텍처는 데이터 처리 아키텍처로 대용량 데이터에 대한  배치 처리와 스트림 처리 방법을 활용하여 처리하기 위해 설계된  데이터 프로세싱 아키텍처이다. 아래의 아키텍처에서 수집된 레코드는 목적에 따라 배치와 실시간 처리 시스템으로 병렬적으로 제공되고 적재된 데이터는 필요 시 데이터를 질의 할 수

By jerryjung
Time series OLAP – Druid Segment(4)

Time series OLAP – Druid Segment(4)

Druid - 새로운 희망 서투른 장인은 항상 연장 나무란다. A bad workman always blame his tools. (속담) 앞선 시리즈에서 자주 언급되었던 Druid의 저장 단위인 Segment와 Druid에서 지원하는 Query에 대해 다루려고 한다. Segment는 Druid의 time기준으로 저장되는 indexing 파일 단위를 의미하며 저장 단위는 사용자 쿼리에 따라 최적화가 가능하다. 저장하려고 하는 데이터의 수집시 indexing

By jerryjung
Time series OLAP – Druid Batch Ingestion(3)

Time series OLAP – Druid Batch Ingestion(3)

Druid - 보이지 않는 위험 위험을 피하려면 최악의 사태를 항상 대비해 두어야 한다. - 그라시안 필자의 경우 Batch Ingestion에서 많은 고통을 느꼈다 ㅠㅠ Druid를 적용하는 케이스가 실시간쪽보다는 배치쪽인 경우가 다수였으며 Batch 의 경우, Druid와의 싸움(?)보다는 MR job에 의존도가 크기에 문제 해결에 상당히 많은 시간이 소요되었다. 혹시나 같은 고통을 겪으실 누군가에게 이

By jerryjung
Time series OLAP – Druid 실시간 수집(2)

Time series OLAP – Druid 실시간 수집(2)

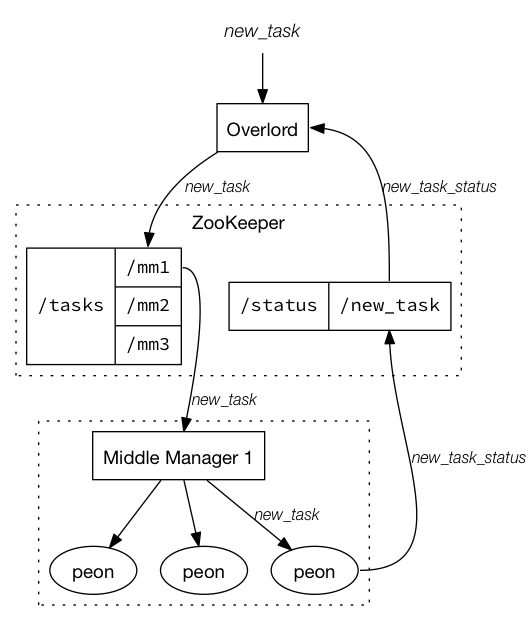
Druid 의 불꽃 전쟁의 서막을 못보셨다면 1편부터 시작 ^^ ::: Druid 입문 당신은 지체할 수도 있지만 시간은 그러지 않을 것이다. - 벤자민 프랭클린 Druid에서 실시간 처리 방식에는 Stream Push방식과 Stream Pull방식이 있다. [참고 : http://druid.io/docs/latest/ingestion/stream-ingestion.html] 실시간 처리 소개 전에 Indexing service에 대해 잠깐 짚고 넘어가자면 다음과

By jerryjung
Time series OLAP - Druid 입문(1)

Time series OLAP - Druid 입문(1)

Druid - 전쟁의 서막 때는 찬바람 불어 호빵을 호호 불며 우물거리던 작년 겨울 Business Problems 쉴틈도 없이 마구마구 뿜어내는 time series 데이터를 어떻게 효율적으로 처리할까라는 고민에서 시작되었다. 빅데이터에는 수많은 오픈소스 기술셋이 존재한다. 적합한 오픈소스는? [참고 : http://xyz.insightdataengineering.com/blog/pipeline_map.html ] Solution 비지니스 요건중에 time series 데이터에 대한 통계를

By jerryjung