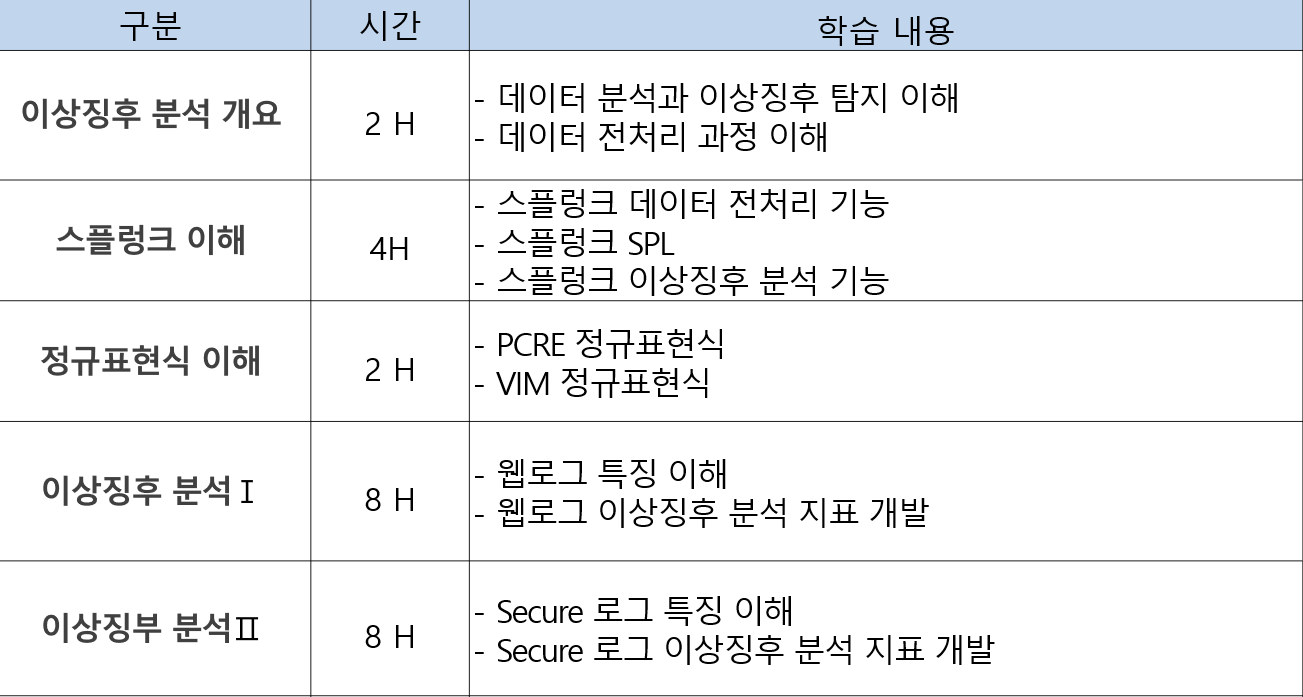
스플렁크 위주로 해주세요
교육기획 담당자로부터 가장 많이 듣는 얘기. 담당자 입장에선 스플렁크 교육으로 결재 받았는데 계획서만 보면 고작 반나절 정도 시간만 할당되어 있으니 답답할만 하다.그래서 각 단위는 스플렁크 필수 기반 기술이거나, 단위 주제 모두 스플렁크를 활용한다는 보충 설명이 필수.왜 이런 상황이 자주 발생할까? 건축 커리큘럼을 보고 망치, 톱질은 언제 배우나 궁금해
 Pop your eXperience. Share It.
데이터 분석 관점의 로그 분석 분야에 관심 많습니다.
교육기획 담당자로부터 가장 많이 듣는 얘기. 담당자 입장에선 스플렁크 교육으로 결재 받았는데 계획서만 보면 고작 반나절 정도 시간만 할당되어 있으니 답답할만 하다.그래서 각 단위는 스플렁크 필수 기반 기술이거나, 단위 주제 모두 스플렁크를 활용한다는 보충 설명이 필수.왜 이런 상황이 자주 발생할까? 건축 커리큘럼을 보고 망치, 톱질은 언제 배우나 궁금해
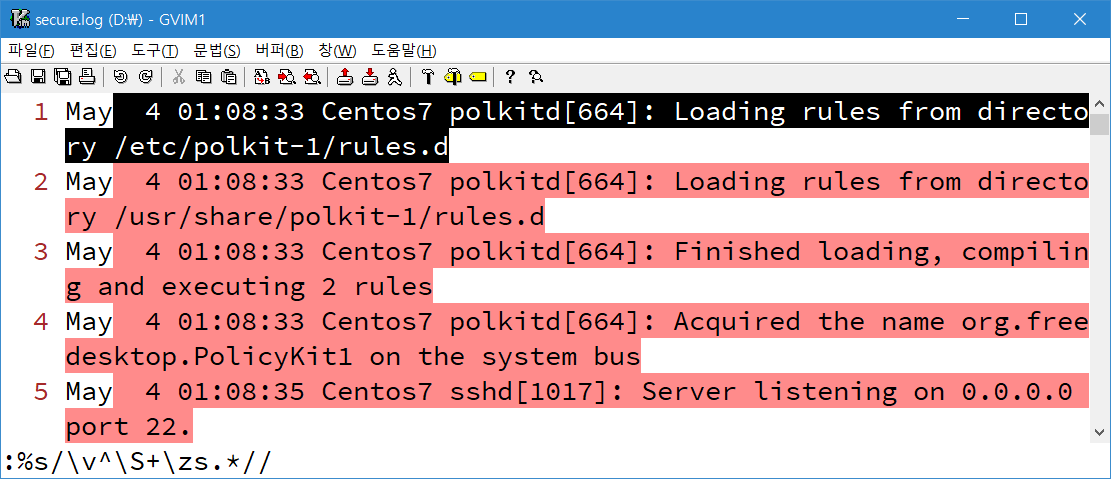
vim을 이용한 월단위 시간 정보 요약. 프로세스 발생 정보 요약. 메시지 발생 정보 요약. 데이터 이해도를 높이기 위한 탐색적 데이터 분석 과정을 진행할 때 가끔 나오는 질문이 있다. VIM 말고 AWK 같은 거 쓰면 안 되나요? why not? 월단위 시간 정보. [root@Splunk ~]# awk '{print $1}' ./secure.log
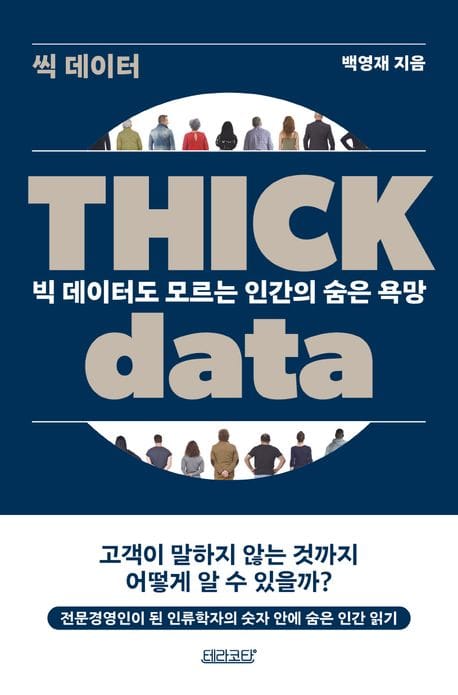
맥킨지, 구글 등 쟁쟁한 이력을 자랑하는 백영재 문화인류학 박사의 2023년작. thick data라는 낯선 용어가 시선을 끈다. 두꺼워? 데이터가? 뭔 말인가 했더니 인류학에서 뭔가를 관찰할 때 고유 맥락과 상황을 포함시켜 연구 대상을 더 구체적이고 풍부하게 묘사하는 thick description에서 따온 말이라고.빅데이터는 표면상으로 드러난 데이터, thick data는 표면에서는 보이지 않는 배경과 맥락을
하나의 로그스태시 파이프라인에서 서로 다른 데이터를 수집, 서로 다른 인덱스에 저장하는 구성에 대한 질문을 받았다. 방법은 input 구간에서 출처별로 수집 플러그인을 분리한 후, output 구간에서 조건에 따라 저장명을 달리하는 것. input { file { path => "a.log" } file { path => "b.log" } } output { if [path] == "a.
로그스태시는 에러 발생 시 상당히 고약한 트러블슈팅 환경을 제공한다. 물론 원인 파악이 쉬울 때도 있음. remove_field 오타 발생. filter { mutate { remove_fiel => ["@version", "@timestamp", "path", "host"] } } 에러 원인을 정확히 찝어준다. [2023-10-22T16:01:47,905][ERROR][logstash.filters.mutate
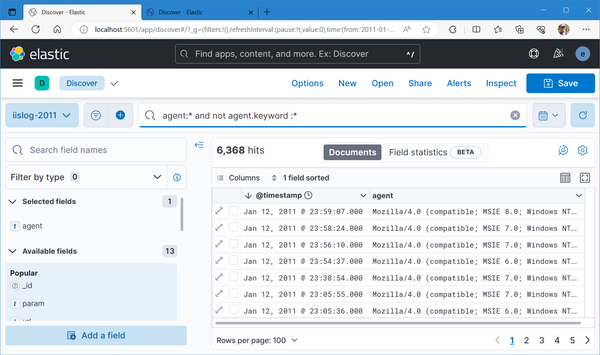
로그스태시를 이용한 데이터 연동 시 문자열 데이터는 형태소 단위로 인덱싱하는 text 타입과 집계 정렬 목적으로 인덱싱을 하지 않는 keyword 타입, 2개의 필드에 저장된다.이때 keyword 타입 필드는 ignore_above 값(기본값은 256)보다 길이가 긴 데이터를 저장하지 않는다고 한다. 실제 text와 keyword 필드를 비교해보니 저장 결과가 다른 상황 발생. ignore_
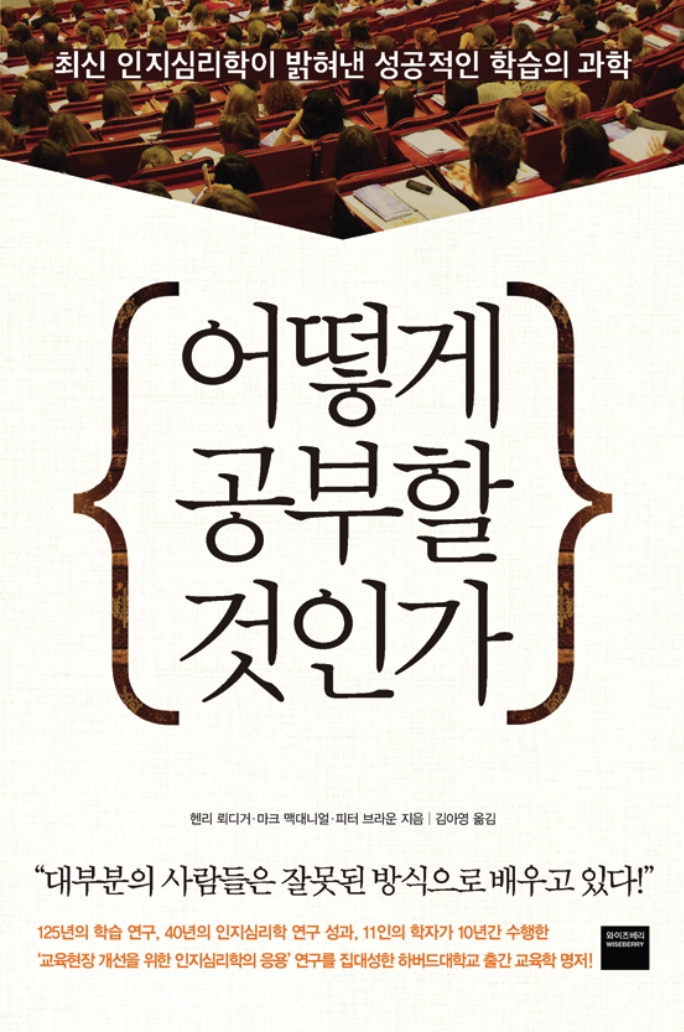
두 명의 심리학자 헨리 뢰디거, 마크 맥다니얼과 작가 피터 브라운이 같이 쓴 2014년작. 공부를 잘하고 싶다면? 주기적으로 복습하면 그 주제를 더 잘 기억할 수 있다 - 5페이지 머릿말에서 비법예습, 복습 철저을 다 알려주는 책. 결국 알고만 있어서는 소용 없고 실천이 중요하다(..) [목차] 1. 우리는 잘못된 방식으로 배우고 있다 2. 배우려면 먼저
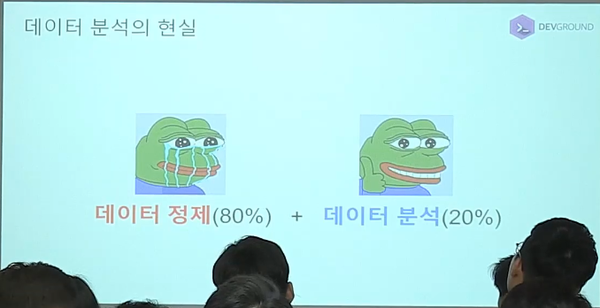
검색엔진은 잘 모르지만 엘라스틱을 데이터 분석툴로 사용할 때 데이터 전처리가 차지하는 비중은 생각보다 크다. 그렇다 보니 자연스럽게 로그스태시 필터 기능을 소개하는 데 많은 시간을 할애한다. 그때 종종 받는 (툴을 잘 쓰면 데이터 분석이 쉬워질거라는 기대가 담긴) 질문. 저 기능들을 언제 다 익혔나요? 그러게? 난 언제 저 기능들을 익혔지? 사실은 익힌
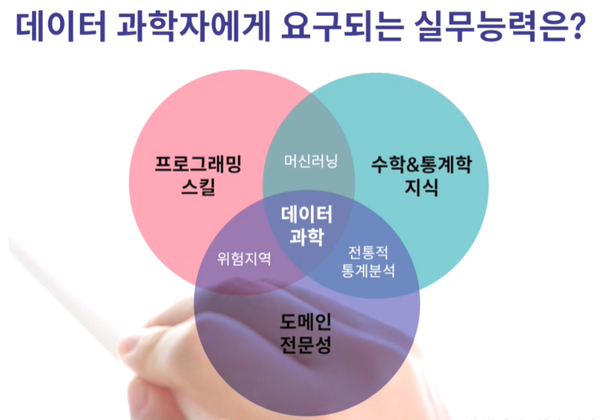
빅데이터가 대세 키워드였던 몇 년 전까지만 해도 하둡 등의 인프라가 모든 것을 해결해줄 듯한 분위기였다면, 알파고 이후엔 수학 및 통계학, 그리고 그런 지식에 기반한 모델링 능력이 필수 자질로 꼽히는 세상이 되었다. 광고, 추천, 번역, 금융 등 많은 분야에서 그런 자질을 요구한다. 열거한 분야들의 공통점은 최종 목적이 결국 돈이라는 것. 돈을
5일 중 3일을 정규표현식에 할애한 과정을 진행하다가 아차(?) 싶었던 첫 강의가 생각난다. 그렇게 정규표현식 비중을 줄이고 줄여서 현재 정규표현식 과정은 반나절 정도(..) 그럼에도 빠지지 않는 질문이 쉬운 정규표현식? 대체 방법? 정규표현식이 쉬워지는 방법은 많이 써보는 수밖에 없다 보니 정규표현식을 사용하지 않고 원하는 테이블 구조를 만드는 방법에 대한 고민을 자주 한다.
다음은 root 사용자의 IP별 접속 현황. 5월 14~16일 및 6월 12일의 IP 변화가 눈에 띈다. 그런데 사용자가 많다면 사용자별 접속 IP의 변화 확인이 꽤 까다로울 것이다. 더 직관적인, 한 눈에 IP 변화를 알아차릴 수 있는 차트를 그릴 수는 없을까? 다음은 root 사용자의 IP 고유 개수 변화. 6월 12일의 변화는
엘라스틱이 sql을 지원하기 시작한지 꽤 됐는데 조인은 아직이다. 그런데 아마존이 배포하는 opendistro는 조인을 지원한다. 물론 아직 조인 내부적으로 집계도 안 되고, 서브 쿼리도 안 먹고 등등 많이 부족함. 하지만 외부 조인까지 지원하는 걸 보면, 빠르게 기능 개선이 이루어지지 않을까 싶다. 아마존이 이렇게 발 빠르게 움직인다면 엘라스틱도 가만 있지 않겠지? 그나저나