
벤치마크 Apache Hive와 Druid를 통한 sub-second 분석 -2편
지난 Ultra-빠른 OLAP분석 시리즈 2편이 블로깅 되어 Ultra-빠르게 요약해 보았다.
이번 글에서는 Apache Hive와 연동된 Druid를 이용하여 초 단위 미만 분석을 수행한 결과를 리포팅하고 있다.
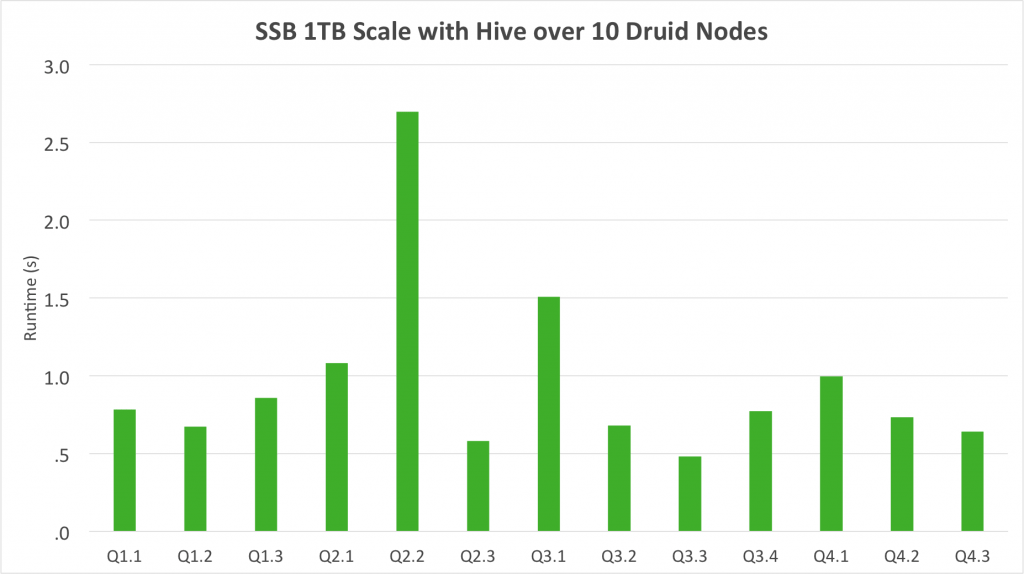
1TB의 OLAP데이터에 대한 벤치마크 결과는 다음과 같다. 평균 쿼리 응답 시간은 1초 미만이다.

Star-schema Benchmark또는 SSB Benchmark는 기존의 데이터웨어 하우스의 응용 프로그램을 지원하는 데이터베이스의 성능을 측정하도록 설계되어 있는 것이다. OLAP질의의 경우 반복인 대화 형식으로 질의를 수행하여 추세 및 경향을 파악하려는 용도로 많이 사용되며 이러한 쿼리는 지연 없이 수초 이내에 응답을 해야 한다.
다음은 SSB쿼리에 Q4.2의 쿼리 문이다. 5개의 table에서 join연산을 수행한 후 group by질의를 통해 연도별, 국가별, 카테고리별 profit을 select하는 쿼리문이다.
select
 d_year, s_nation, p_category,
 sum(lo_revenue – lo_supplycost) as profit
from
 dates, customer, supplier, part, lineorder
where
 lo_custkey = c_custkey
 and lo_suppkey = s_suppkey
 and lo_partkey = p_partkey
 and lo_orderdate = d_datekey
 and c_region = ‘AMERICA’
 and s_region = ‘AMERICA’
 and (d_year = 1997 or d_year = 1998)
 and (p_mfgr = ‘MFGR#1’ or p_mfgr = ‘MFGR#2’)
group by
 d_year, s_nation, p_category
order by
 d_year, s_nation, p_category;
이 쿼리는 Star Schema의 모든 테이블을 포함하고 각 차원 테이블에 필터 조건을 주도록 되어있다. 해당 쿼리는 전체 행의 0.5% 미만을 접근이 요구 되며 Druid의 인덱싱이 빠른 분석을 제공하는지에 대한 적절한 예에 해당한다.
Hive에서 OLAP Index를 생성하기
다음과 같이 데이터베이스를 만들고 index관련 설정을 수행한다.
create database ssb_druid;
use ssb_druid;
set hive.druid.metadata.uri=jdbc:mysql://db.example.com/druid_benchmark;
set hive.druid.indexer.partition.size.max=9000000;
set hive.druid.indexer.memory.rownum.max=100000;
set hive.tez.container.size=16000;
set hive.tez.java.opts=-Xmx10g -XX:MaxDirectMemorySize=1024g -Duser.timezone=”America/New_York”;
set hive.llap.execution.mode=none;
ssb_druid_month테이블을 생성한다. 기존 Hive table로부터 데이터를 join하여 OLAP Index를 생성하는 것이다. pre-aggregation단위는 DAY기준으로 집계가 되며 segment저장 단위는 MONTH이다. String타입은자동으로 dimension으로 처리되고 Numeric속성의 경우 자동적으로 metric(sum,min,max 등) 집계가 생성된다. 아래의 예에서 집계의 기준이 되는 timestamp필드는 __time이다.
CREATE TABLE ssb_druid_month
STORED BY ‘org.apache.hadoop.hive.druid.DruidStorageHandler’
TBLPROPERTIES (
 “druid.datasource” = “ssb_druid”,
 “druid.segment.granularity” = “MONTH”,
 “druid.query.granularity” = “DAY”)
AS
SELECT
 cast(d_year || ‘-‘ || d_monthnuminyear || ‘-‘ || d_daynuminmonth as timestamp) as `__time`,
 cast(c_city as string) c_city,
 cast(c_nation as string) c_nation,
 cast(c_region as string) c_region,
 cast(d_weeknuminyear as string) d_weeknuminyear,
 cast(d_year as string) d_year,
 cast(d_yearmonth as string) d_yearmonth,
 cast(d_yearmonthnum as string) d_yearmonthnum,
 cast(lo_discount as string) lo_discount,
 cast(lo_quantity as string) lo_quantity,
 cast(p_brand1 as string) p_brand1,
 cast(p_category as string) p_category,
 cast(p_mfgr as string) p_mfgr,
 cast(s_city as string) s_city,
 cast(s_nation as string) s_nation,
 cast(s_region as string) s_region,
 lo_revenue,
 lo_extendedprice * lo_discount discounted_price,
 lo_revenue – lo_supplycost net_revenue
FROM
 ssb_1000_flat_orc.customer, ssb_1000_flat_orc.dates,
 ssb_1000_flat_orc.lineorder,
 ssb_1000_flat_orc.part, ssb_1000_flat_orc.supplier
where
 lo_orderdate = d_datekey and lo_partkey = p_partkey
and lo_suppkey = s_suppkey and lo_custkey = c_custkey;
위와 같이 별도의 색인 과정을 거칠 필요 없이 간단하게 Hive의 Crate Table As Select(CTAS)로 OLAP Indexing이 가능하다. 이렇게 색인 과정을 table선언으로 마친후에 질의를 수행하게 되면 Hive의 쿼리는 Druid broker로 전달되어 OLAP Indexing결과를 리턴하게 된다.
검색어 조정
리포팅 용 질의와 BI쿼리등은 특정 쿼리로 정렬하게 되는데 BI도구는 동적이고 유연하게 클라이언트에서 정렬을 처리하기 때문에 데이터베이스에 의존하여 정렬하지 않는다. 사용자가 Tableau와 같은 BI도구에서 사용한다는 가정하게 OLAP index 생성시 ORDER BY 절을 제거하고 기간에 대한 필터 조건을 (between-관련하여 진행중) 주고 질의 쿼리는 다음과 같이 재작성하였다.
select
 d_year, s_nation, p_category,
 sum(net_revenue) as profit
from
 ssb_druid
where
 c_region = ‘AMERICA’
 and s_region = ‘AMERICA’
 and (d_year = ‘1997’ or d_year = ‘1998’)
 and (p_mfgr = ‘MFGR#1’ or p_mfgr = ‘MFGR#2’)
group by
 d_year, s_nation, p_category;
테스트에 수행된 전체 쿼리는 다음을 참조하면 된다. 위에서 실시했던 벤치마크는 HiverServer2를 띄우고 JDBC를 통해 실행되었다. 평균 런타임은 960ms이고 최소 런타임은 481ms이며 최대값은 2700ms이다.
클러스터 세부사항 (튜닝노트)
- 10 nodes
- 2x Intel(R) Xeon(R) CPU E5-2640 v2 @ 2.00GHz with 16 CPU threads each
- 256 GB RAM per node
- 6x WDC WD4000FYYZ-0 1K02 4TB SCSI disks per node
사용해보기
HDP2.6에서 Druid가 Technical Preview형태로 제공되며 Ambari를 통해 Druid를 쉽게 deploy할 수 있다.
이건 어디까지나 개인적인 의견으로 이번 블로그에서는 Druid는 열일 했는데 Hive가 브릿지 역할을 하면서 공을 세운 느낌은 지울 수 없다. 하지만 예전부터 Druid를 사용하기에 재한적이였던 부분 -Druid의 Query/Ingestion interface에 대한 대안으로 Hive의 SQL을 사용 - 많은 부분을 간소화 시키고 JDBC도 덤으로 얻는것은 분명 좋은 일이다.



