jerryjung

jerry jerry gogo

Time Series OLAP - Druid Trouble Shooting(6)

Time Series OLAP - Druid Trouble Shooting(6)

Druid - 오른손이 하는 일을 왼손이 모르게 하라 길고 길었던 Druid 시리즈 연재의 마무의리...이렇게 오래 걸릴줄은..... 그사이 Druid는 2018년 2월에 Apache Incubator Project가 되었다. 실시간 Index Task 1. tranquility를 사용해야 하냐?  supervisor(kafka-index-service)를 사용해야 하나? tranquility의 경우 실시간 데이터에 대한 push 방식, supervisor의 경우 input source로 부터
By jerryjung
Spark2.0 New Features(2) Structured Streaming - 1편

빅데이터

Spark2.0 New Features(2) Structured Streaming - 1편

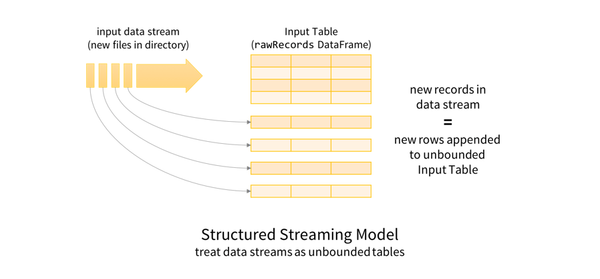
Structured Streaming Structured Streaming은 Spark2.X에서 새롭게 나온 Spark SQL엔진 위에 구축된 Stream Processing Framework이다. Structured Streaming은 기존에 Spark APIs(DataFrames, Datasets, SQL)등의 Structured API를 이용하여 End-to-End Streaming Application을 손쉽게 만들 수 있다. 또한 input data에 대한  Streaming데이터 처리 후 checkpointing과 write-ahead logs를 통한 exactly-once하고

By jerryjung
Hive에서 Druid로 주저 없이 데이터 적재하기[번외:airflow]

druid

Hive에서 Druid로 주저 없이 데이터 적재하기[번외:airflow]

Hive에 있는 데이터 Druid에 적재하려면? 다음과 같은 다양한 삽질 방법이 존재한다. 1. Hive에 metastore로부터 hdfs location을 파악한 후 orc format이나  parquet format이냐에 따라 그에 맞는 hadoop ingestion spec을 작성해야함. orc인 경우 struct type정보를 잘 파악해야하며,  parquet인 경우에는 avro schema를 읽기 때문에 orc에 비해 덜 번거롭다. 자세한 내용은 요기를 참고:  ORC

By jerryjung
[후기글] DEVIEW 2017 DAY2

[후기글] DEVIEW 2017 DAY2

난생 처음 DEVIEW에 가보다 매년 DEVIEW 시즌이면 항상 이래저래 일이 생기거나 신청이 늦어 10년동안 한차례도 참석해 본적이 없었다. DEVIEW는 네이버가 주관하는 국내 최대 개발자 컨퍼런스 행사로 올해로 10주년을 맞았다. DAY1은 아쉽게 놓쳤지만 DAY2에 참석한 소감과 발표된 내용에 대한 간단 리뷰를 작성해 보려고 한다. 세션은 주관적인 취향에 의해 선택된 것이므로 몸이

By jerryjung
벤치마크 Apache Hive와 Druid를 통한  sub-second 분석 -2편

벤치마크 Apache Hive와 Druid를 통한 sub-second 분석 -2편

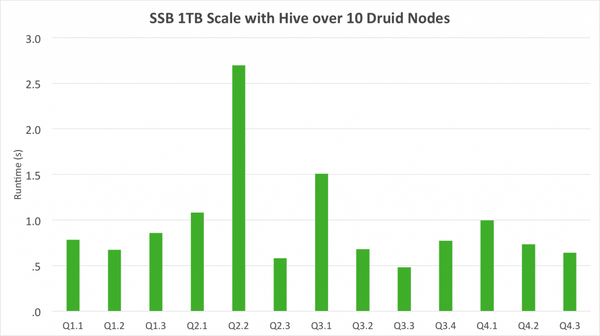
지난 Ultra-빠른 OLAP분석 시리즈 2편이 블로깅 되어 Ultra-빠르게 요약해 보았다. 이번 글에서는 Apache Hive와 연동된 Druid를 이용하여 초 단위 미만 분석을 수행한 결과를 리포팅하고 있다. 1TB의 OLAP데이터에 대한 벤치마크 결과는 다음과 같다. 평균 쿼리 응답 시간은 1초 미만이다. Star-schema Benchmark또는 SSB Benchmark는 기존의 데이터웨어 하우스의 응용 프로그램을

By jerryjung
Hive 와 Druid로 울트라-빠른 OLAP 분석하기-1편

Hive 와 Druid로 울트라-빠른 OLAP 분석하기-1편

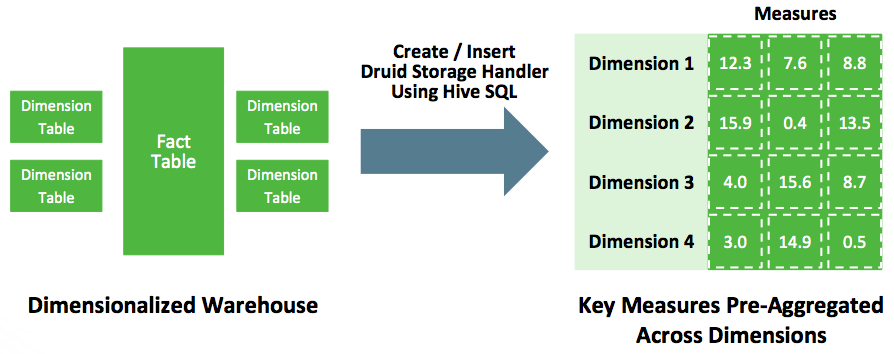
다음 글은 https://hortonworks.com/blog/apache-hive-druid-part-1-3/  포스팅에 대한 요약글이다. 아직 part1 만 시작한 글이지만 얼마나 좋길래? 울트라란 용어를 남발하였는지 살펴 보기로 하자. 한줄 요약하자면 SQL-on-Hadoop기술의 de-facto Hive와 OLAP engine Druid가 만나 초고속 분석을 제공한다는 이야기이다. Druid는 고성능 컬럼 기반 분산 데이터

By jerryjung

kubernetes 어디까지 써봤니? 삽질기(2)

Kubernetes 삽질하다 일어난일 kubernetes 삽질의 시작은 이전글을 참조하기 바란다. 이번 글에서는 나의 작은 실수로 인해 분석가를 식겁하게 한 에피소드에 대해 이야기 해 보려 한다. 그전에 k8s에 deploy하기 위한 기본 개념에 대해 살펴볼 예정이다. pod로 띄우기 pod는 한개 이상의 컨테이너로 구성되는 k8s에서 가장작은 deploy를 위한 단위이다. 이는 자신의 어플리케이션 스택에 서로

By jerryjung

kubernetes 어디까지 써봤니? 삽질기(1)

Kubernetes 삽질의 시작 이 글은 kubernetes관련 삽질기로 시리즈로 연재될 예정이다. kubernetes에 대한 소개는 이전글을 참조하기 바란다. kubernetest(이하 k8s)는 오픈소스 컨테이너 관리 툴이다. k8s는 Go언어로 개발되어 있으며 경량의 이식 가능한 어플리케이션이다. k8s를 Linux기반의 OS에 올려 다수의 호스트에 클러스터 풀을 생성한후 docker컨테이너 어플리케이션을 올리고 관리하고 확장 가능하게 설정할 수 있다.

By jerryjung
[TIP] git을 sql로 확인하기~ 막일을 줄이기 위한 유용한 팁 3

[TIP] git을 sql로 확인하기~ 막일을 줄이기 위한 유용한 팁 3

git 을 sql로 질의하다 이번 시리즈는 사실 개발자의 막일을 줄인다기 보다 git 정보를 재미나게(?) 볼 수 있는 툴 하나를 소개 하려한다. gitql 은 git 레포지토리를 sql로 볼 수 있는 툴이다. go로 개발되어 있으며 gitql을 설치 한 후 기존 레포지토리에서 명령어와 함께 sql을 보고자 하는 필드와 테이블을 지정하여 실행시키면 (예를 들어

By jerryjung
[TIP] Slack으로 막일을 줄여요 ~ 막일을 줄이기 위한 유용한 팁 2

[TIP] Slack으로 막일을 줄여요 ~ 막일을 줄이기 위한 유용한 팁 2

메신저 기반의 협업 툴 Slack 이번 팁글에서는 Slack에 대해 약간은 고급진(?) 활용법에 대해 공유하려고 한다. slack은 팀원들간의 협업을 돕는 툴로 다양한 장점이 있지만 무엇보다도 다른 툴과의 연동일 것이다. 손쉬운 코드 공유/ 파일 공유 부터 시작해서 검색 등등 기본기능외에도 기존 협업 툴과 아주 손쉽게 연동이 가능하다. 요즘 세대들은 톡으로 모든것을 공유한다.

By jerryjung
[삽질기] JDBC를 통한 하둡 적재, 알면 도움되는 삽질 이야기 1편

[삽질기] JDBC를 통한 하둡 적재, 알면 도움되는 삽질 이야기 1편

Pain past is pleasure! 이번 글에서는 JDBC를 통해 하둡에 데이터를 적재할때 한번 쯤 고민해 볼만한 주제로 삽질기를 공유하려고 한다. 먼저 필자가 경험한 내용은 아주 특이한 케이스로 일반적인 경우에 해당되지 않는다. 주위에 이런 삽질을 하는 사람도 있구나 라고 참고만 하시길... 기존 레거시에 있는 데이터 베이스로부터 하둡에 데이터를 적재할 때, 가장 많이

By jerryjung