Latest

Hive에서 Druid로 주저 없이 데이터 적재하기[번외:airflow]

druid

Hive에서 Druid로 주저 없이 데이터 적재하기[번외:airflow]

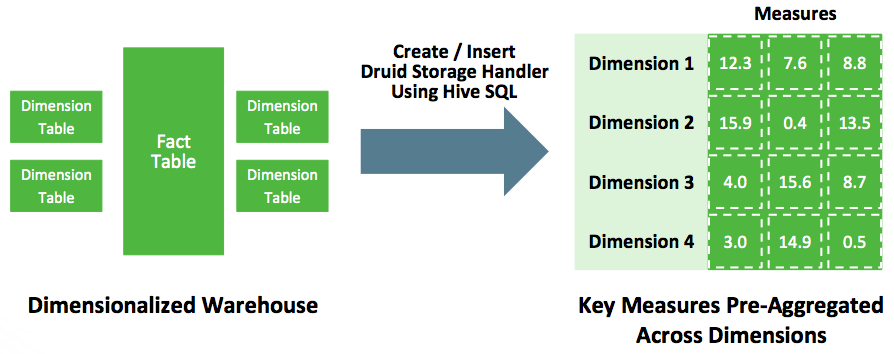
Hive에 있는 데이터 Druid에 적재하려면? 다음과 같은 다양한 삽질 방법이 존재한다. 1. Hive에 metastore로부터 hdfs location을 파악한 후 orc format이나  parquet format이냐에 따라 그에 맞는 hadoop ingestion spec을 작성해야함. orc인 경우 struct type정보를 잘 파악해야하며,  parquet인 경우에는 avro schema를 읽기 때문에 orc에 비해 덜 번거롭다. 자세한 내용은 요기를 참고:  ORC
By jerryjung
이제 아키텍트는 필요없다, 아키텍처를 이해하는 전문가가 필요할 뿐

아키텍처

이제 아키텍트는 필요없다, 아키텍처를 이해하는 전문가가 필요할 뿐

팝잇에 예전에 썼던 글의 댓글을 한참 후에 발견했다. 그러던 중, 하나의 글에 달린 댓글에 답변을 달고 있는데 데자뷰가 느껴졌다. 언젠가 이런 일을 했던 느낌... 다시 아키텍트란 개념를 만나다 올 봄, 그러니 무려 7개월 전에 댓글 중 일부에 대한 답으로 다음 글을 썼다. 어이없었다. 까맣게 잊고 다시 똑같은 댓글을 길게 쓸뻔했다.

By 안영회
윈도우즈기반 도커에 Postgres-XL 설치하기

bigdata

윈도우즈기반 도커에 Postgres-XL 설치하기

빅데이터용 RDBMS가 필요해! 인터파크 사내에 추천시스템을 제공하기위해서 수많은 상품과 사용자 데이터를 마이닝하고 모델링을 거친 추천 상품들을 핸들링하기 위한 RDBMS가 필요했습니다. (그러나,,, RDBMS가 꼭 필요한 경우가 아니라면, 오픈소스 MPP 보단 가급적 Parquet 또는 다른 하둡 에코를 이용하시는게 정신건강에 이롭습니다.) 후보 솔루션 및 솔루션 선정 찾아본 솔루션은 다음과 같습니다. * Cockroach DB : Raft

By Jeon Deuk Jin
객체지향적인 Go 프로그래밍이란?

객체지향적인 Go 프로그래밍이란?

동료들의 부족한 설계 능력을 보고 있자니 할 수 없이 Go 코드[1]를 봐야 했다. 한편, 내 옆에 앉는 김형준님은 회사의 거의 모든 코드를 리뷰하며 나에게 감상평을 한다. 종종 번거롭다는 생각이 들기도 하지만, 워낙 열심히 설명을 하시니 다른 일을 하다가도 잠시 집중력을 발휘하여 들어보려고 노력한다. 꼭, 뭔가 직접적인 도움을 주지

By 안영회
마이크로 서비스(MSA)로 구축할 때 모듈은 어떤 단위로 할까?

마이크로 서비스(MSA)로 구축할 때 모듈은 어떤 단위로 할까?

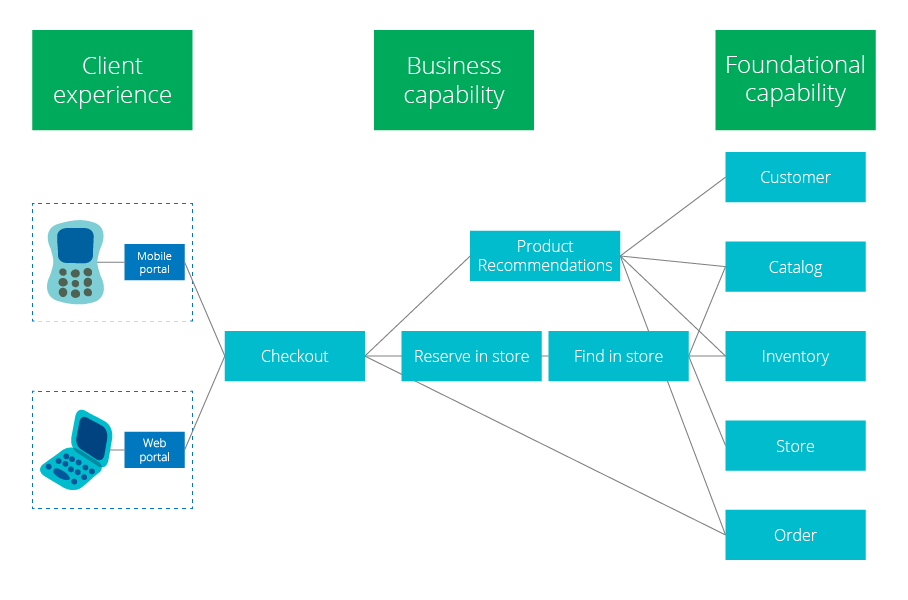
답이 없는 문제지만, 시작할 때 도움이 되는 cheatsheet 정도를 제공할 목적으로 글을 쓴다. 참조 모델 결론은 아래 그림이다. 물론, 모든 상황에 맞는 답은 없다. 우리 환경에 맞추면 REST 형태로 API를 제공하는 웹 서비스를 모듈이라는 단위로 부른다. 위 그림에서 Foundational capability와 같다. 하지만, 모듈이 하나로 배포되는지 사실은 유사한 API 묶음이 여러

By 안영회
마이크로 서비스 구축 경험 공유

마이크로 서비스 구축 경험 공유

아키텍처, 시스템 구성, 모델링, 개발 프로세스를 고민하고 만들었다기 보다는 현재의 조직 구성원으로 서비스를 만들 수 있는 가장 최선의 방법을 선택한 것입니다. 복잡한 것은 만들기 어려우니 아주 잘게 쪼개고, 잘 만들고 있는지도 모르겠으니 일주일에 한번씩 확인하는 방식이었던 것입니다. 우리의 여정이 11개월째로 접어들 때 합류한 김형준님이 내 의도를 너무나 잘 정의했다.[1]

By 안영회
시스템 개선을 위한 REST API 도입?

시스템 개선을 위한 REST API 도입?

안내: 이 글은 운영을 중단한 개인 블로그에 2015년 6월 9일 올렸던 글입니다. 다음에 기고할 글과 연관이 있어 옮겨 둡니다.   어떤 경로나 동기로 찾았는지 지금은 기억나지 않지만, StackOverflow의 REST 관련 질문이 눈에 들어왔다. 인터페이스 계층과 비즈니스 계층 사이에 인터페이스로 API를 두는 것이 바람직한 아키텍처 설계인지 그리고 API 구축에 REST를 채용하는 것이

By 안영회
Hadoop-3.0과 Erasure Coding 편집증

Hadoop-3.0과 Erasure Coding 편집증

안녕하세요. 오늘은 하둡3.0과 Erasure Coding에 대하여 얘기를 하고자 합니다. 저희 회사에서도 시스템 로그 및 유저 액티비티 로그들을 적재 할 공용 저장소 시스템을 구축 할 필요가 있게 되어서, 하둡을 사용하게 되었습니다. 아직 하둡 알파버전이지만, 3.0 버전에 대한 내용을 접한 곳은 홍태희님의  "업그레이드를 부르는 Hadoop 3.0 신규 기능

By Jeon Deuk Jin
Hive 와 Druid로 울트라-빠른 OLAP 분석하기-1편

Hive 와 Druid로 울트라-빠른 OLAP 분석하기-1편

다음 글은 https://hortonworks.com/blog/apache-hive-druid-part-1-3/  포스팅에 대한 요약글이다. 아직 part1 만 시작한 글이지만 얼마나 좋길래? 울트라란 용어를 남발하였는지 살펴 보기로 하자. 한줄 요약하자면 SQL-on-Hadoop기술의 de-facto Hive와 OLAP engine Druid가 만나 초고속 분석을 제공한다는 이야기이다. Druid는 고성능 컬럼 기반 분산 데이터

By jerryjung
아마존에서 MS로 옮긴 백기선씨 이야기

아마존에서 MS로 옮긴 백기선씨 이야기

우리나라 문화와 달리 쿨cool 할 것으로 여겼던 미국회사에서 겪은 쿨하지 않은 측면을 아마존에서 봤습니다. 아마존 입사 후 1년 동안 겪은 일련의 사건이 저를 돌아보는 좋은 기회도 된 것이 사실이에요. 다만, 그러면서 자신감도 많이 잃었습니다. 그러던 차에 한줄기 빛으로 저에게 손을 내밀어 준 것이 마이크로소프트(MicroSoft)입니다. 1편은 여기서 확인: 아마존

By 안영회
기능이 형태를 지배해야 한다

기능이 형태를 지배해야 한다

아래는 문래학당 임춘봉훈장님께서 편집해주신 루이 설리번의 고전이다. 내가 아키텍트 혹은 설계자로써 딱 하나 잊지 않는 유일한 공학원리 항목이기도 하다. 공학적 배경지식이 없거나 건축에 소프트웨어 설계 은유를 하는 부분이 생소한 분을 위해 가벼운 글을 쓴다.   핵심가치가 무엇이냐? 혹은 너 기능이 뭐야? 가장 중요한 질문이다. '당신은 뭐하는 사람이냐?'라는 질문이

By 안영회