데이터분석
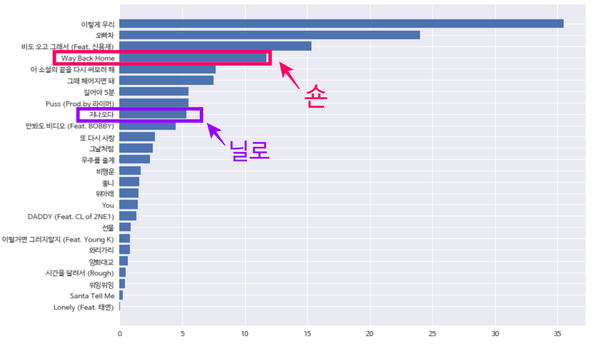
사람들은 왜 숀 안 대고 닐로 먹기라고 느꼈을까?
* 현재 언쟁 중인 어뷰징의 사실 여부는 다루지 않습니다. 대중의 어뷰징 판단에 어떠한 근거에서 촉발된 것인지만을 다룹니다. 원래 이걸 하려고 크롤링한 데이터는 아니었지만 어쩌다보니(내 인생 모토..) 지니 일별 차트를 3년치 정도 크롤링했다. 때마침 숀이 차트 1위를 하면서 어뷰징이다 아니다 의견이 분분하길래 데이터를 좀 더 자세히 들여다봤다. 그게 사실인지 아닌지는 내가
 Pop your eXperience. Share It.
데이터분석
* 현재 언쟁 중인 어뷰징의 사실 여부는 다루지 않습니다. 대중의 어뷰징 판단에 어떠한 근거에서 촉발된 것인지만을 다룹니다. 원래 이걸 하려고 크롤링한 데이터는 아니었지만 어쩌다보니(내 인생 모토..) 지니 일별 차트를 3년치 정도 크롤링했다. 때마침 숀이 차트 1위를 하면서 어뷰징이다 아니다 의견이 분분하길래 데이터를 좀 더 자세히 들여다봤다. 그게 사실인지 아닌지는 내가
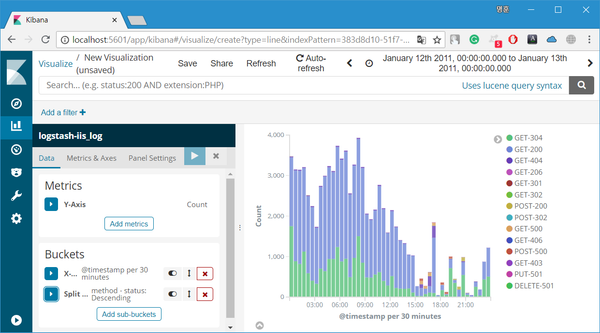
키바나 기능 중에 'scripted field'라는 게 있다. 무엇에 쓰는 물건인가 싶어 찾아보니 '중요한 값을 스키마에서 별도 필드로 정의하지 못하였거나 또는 두 개 필드를 결합하여 단일 필드로 처리하고자 하는 경우'에 유용한 기능이라고. 로그스태시 연동할 때 깜박하고 로그 필드 정의 빼먹었다가 처음부터 다시 하는 불상사를 막을
Druid - 오른손이 하는 일을 왼손이 모르게 하라 길고 길었던 Druid 시리즈 연재의 마무의리...이렇게 오래 걸릴줄은..... 그사이 Druid는 2018년 2월에 Apache Incubator Project가 되었다. 실시간 Index Task 1. tranquility를 사용해야 하냐? supervisor(kafka-index-service)를 사용해야 하나? tranquility의 경우 실시간 데이터에 대한 push 방식, supervisor의 경우 input source로 부터
급변하는 날씨를 예측하려면 어떠한 정보가 있어야 할까? 또는 마트를 운영하는 담당자인 경우 매장 운영시간을 정해야 한다면 어떠한 기준으로? 뜨거운 감자인 비트코인 시장에서 수익을 얻으려면 어떤 정보들이 있어야 물리지(?) 않을수 있을까? 위 질문에 공통된 정답은 예전 기록들인것 같다. 날씨예측은 기상청에서 과거 기록들을 보고 비가 올지 말지를 결정하고 ( 과거 날씨 서비스를 담당해봤지만
빅데이터
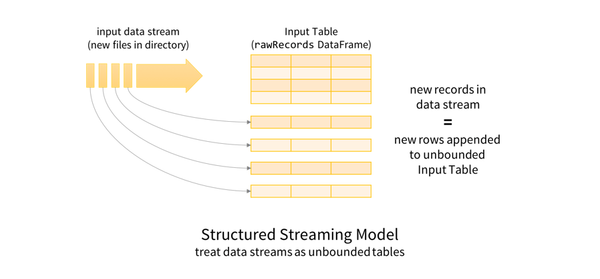
Structured Streaming Structured Streaming은 Spark2.X에서 새롭게 나온 Spark SQL엔진 위에 구축된 Stream Processing Framework이다. Structured Streaming은 기존에 Spark APIs(DataFrames, Datasets, SQL)등의 Structured API를 이용하여 End-to-End Streaming Application을 손쉽게 만들 수 있다. 또한 input data에 대한 Streaming데이터 처리 후 checkpointing과 write-ahead logs를 통한 exactly-once하고
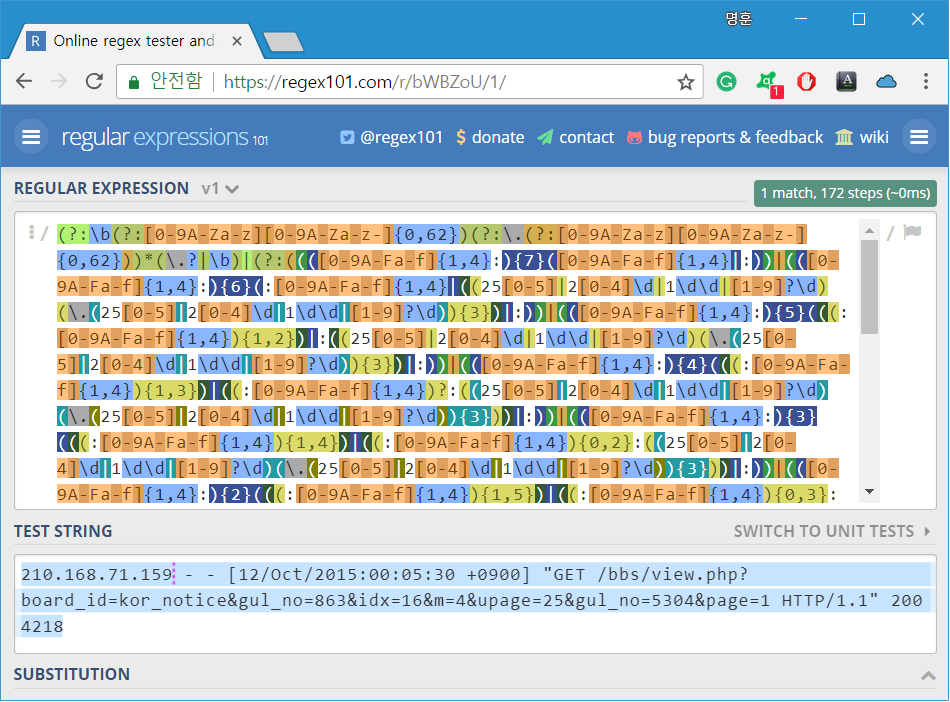
로그 분석을 데이터 분석 수준으로 끌어올리려면 원시로그 덩어리를 필드별 고유성이 확보된 테이블 구조로 바꿔야 하는데, 이때 grok 필터의 역할은 독보적이다. 한가지 단점이라면 정규표현식을 이용하기 때문에 성능이 저하될 수 있다는 것. grok 필터는 로그스태시 필터링 성능에 얼마나 영향을 끼칠까? 윈도우8, i5(CPU), 8GB(Memory), SSD(mSATA) 사용 환경에서 아파치 웹로그 백만
여는 글 최근 아파치 하둡 3.1.0의 출시로 HDFS 의 Erasuere Coding 외에 분산 자원 관리자인 YARN에 특히 실용적인 기능들이 적용되었는데, 어떠한 기능들인지 차근차근 소개하겠습니다. 먼저, 공식 사이트에 게시 된 개요로부터 시작 하겠습니다. 개요 이 글에서는 주요 변경 사항에 대한 간략한 개요를 제공합니다. * YARN 기반에서 장기 실행 서비스들을 native와
여는 글 최근 재미나게 본 영화인 Ready Player One 의 한 컷으로 글을 시작합니다. 이 영화에서 처럼 저와 독자분들께서도 자신의 인생에서 보지 못한 것을 볼 수있는 통찰력을 갖게 되기를 희망합니다. 독서 시간 : 3분 | 발췌... 글의 제목에서 알 수 있듯이, 이 글은 Spark Streaming 입문서가 아닙니다. 솔직히 이 글은 Spark 및
Desktop 및 스마트폰의 대중화로 다양한 OS와 브라우저들을 사용하게 되었다. 이때, 내가 운영하는 웹서버에 들어오는 사람들은 무슨 기기로 접속을 하는 것일까? 혹여 특정 OS의 특정 브라우저에서만 안되는 버그를 잡기 위해 몇일밤을 고생하며 겨우 수정했는데… 과연 그 OS의 브라우저에서는 접속은 하기나 하는걸까? (ㅠㅠ) 만약, 접속 사용자의 Device 정보를 알고있다면 고생하며 버그를 잡기
가끔 엘라스틱서치에서 특수문자를 검색하고 싶을 때가 있는데 잘 안 된다. 다음은 var 필드에서 특수문자 '='을 포함한 모든 문자열을 검사하는 '*=*'의 검색 결과. 검색 결과가 없는 이유는 엘라스틱서치가 인덱스 색인을 만드는 과정에서 특수문자를 '공백' 취급해버리기 때문. 다음은 문자열 'a=d'의 인덱싱 결과.
이번 글에서는 kafka에서 사용하는 토픽의 Replication Factor(이하 RF)를 변경하는 방법에 대해 설명하겠습니다. kafka에 대한 예전 글들도 있으니 필요하신 분들은 참고하시면 좋을 것 같습니다. Kafka 운영자가 말하는 처음 접하는 Kafka Kafka 운영자가 말하는 Kafka Consumer Group Kafka 운영자가 말하는 Producer ACKS Kafka 운영자가 말하는 Kafka 서버 실전 로그 분석
Hive의 CLI 명령을 Crontab에 등록하여 주기적으로 작업하는 경우가 가끔있습니다. 예를 들면 로그를 매일 새로운 파티션에 저장하는 경우 강제적으로 Hive에 파티션을 추가해야 하는 작업 등이 있습니다. 보통 Crontab의 shell 환경은 터미널로 접속했을 때와의 shell 환경과는 조금 차이가 있는데, 이번 글은 이런 차이로 인해 발생한 문제 및 삽질기에 대한 내용입니다. 문제 상황