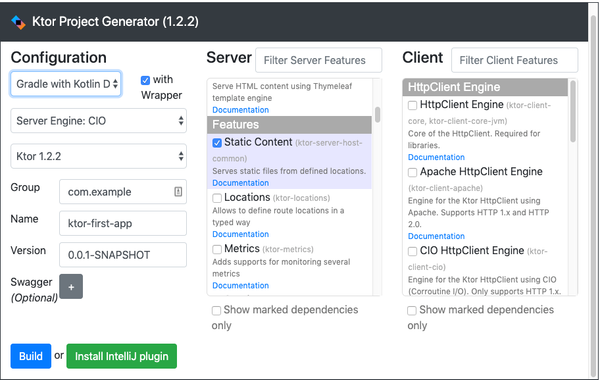
코틀린 웹 프로그래밍 using Ktor (1)
ver: 1.1 잡담 저는 함수형 프로그래밍에 관심이 많고 호주로 이민와서 닷넷 개발자로써 8년 넘게 생활하면서 익힌 기술들을 기반으로 닷넷개발 자를 위한 함수형 프로그래밍( C# - C# (more functional style) - F#을 비교하는 방식으로) 책을 써보려고 했습니다. 하지만 한국에서 닷넷은 자바에 비해 너무도 시장이 작고 거기다 중고급서는 출판이 어렵다는 출판사 담당자
 Pop your eXperience. Share It.
ver: 1.1 잡담 저는 함수형 프로그래밍에 관심이 많고 호주로 이민와서 닷넷 개발자로써 8년 넘게 생활하면서 익힌 기술들을 기반으로 닷넷개발 자를 위한 함수형 프로그래밍( C# - C# (more functional style) - F#을 비교하는 방식으로) 책을 써보려고 했습니다. 하지만 한국에서 닷넷은 자바에 비해 너무도 시장이 작고 거기다 중고급서는 출판이 어렵다는 출판사 담당자
[원본글] https://ericygkim.wordpress.com/2019/07/11/aws-ebselastic-block-storage-의-비용-최적화/ 애플리케이션 개발 후 AWS에 애플리케이션을 설치할 때 성능, 가용성, 확장성, 비용, 서비스 특성등 많은 요구사항들을 고려하여 복잡한 고민을 거쳐 EC2 인스턴스 사이즈등 AWS 자원들을 선택하게 됩니다. 그 중 중요한 요소 중 하나가 EC2인스턴스나 RDS에 연결되는
카프카 보안과 커버로스(Kerberos)를 이용해 구성하는 방법에 대해 다루는 글을 쓰려다가, 현재 제가 구성한 보안 클러스터 구성환경에 접속할 수도 없고 새로 구성하기도 어려운 상황이라, 평소 주위 분들에게 많은 질문을 받은 “빠르게 카프카 사용하기”라는 주제로 먼저 글을 써봐야겠다는 생각이 들었습니다. 이 내용은 생각보다는 매우 단순하고 쉽습니다. 이 글이 필요한
지난번 <실체가 손에 잡히는 딥러닝> 1편 "인공지능의 세계, 머신러닝과 딥러닝은 어떻게 등장했나"에서는 인공지능과, 머신러닝, 딥러닝의 관계를 짧게 살펴보았는데요. 요즘 어쩌면 IT산업분야에서 가장 뜨거운 감자라고 할 수 있을 머신러닝과 딥러닝에 대한 팝잇 독자분들의 반응을 느낄 수 있었습니다. 감상을 접할 기회는 없었지만 독자분들의 따뜻한 성원에 힘입어 이번
얼마전 제가 번역한 실체가 손에 잡히는 딥러닝, 기초부터 실전 프로그래밍(책만)이라는 책이 출간되었습니다. 저는 현재 대학교에서 머신러닝과 딥러닝을 이용해 데이터 분석과 인공지능 서비스 기획 업무를 진행하고 있는데, 마침 일본에서도 머신러닝과 딥러닝 분야의 베스트셀러에 오른 이 책을 출간하면서 딥러닝에 대해 전체적으로 정리할 수 있는 기회가 있었습니다. 이 경험을 바탕으로 앞으로
클라우드 소프트웨어 서비스 산업이란 장르에서 아직 정제되지 않은 우리의 진보에 대해 기록하려고 한다. 이 글은 개념적으로 잘 정제된 용어나 기술을 다루는 대신에 타이밍을 다투는 비즈니스 시장에서 벌어지는 실제 이야기를 담는데 그 가치를 두려 한다. 또한, 중국시장에서 한국 개발자가 주도하여 중국 개발자들과 함께 이제 막 열리고 있는 SaaS 시장에 도전하는 우리의
해당 코드는 Github를 확인해주세요. JpaRepository의 쿼리 메서드를 통해서 간단한 쿼리들을 아래 예제 처럼 쉽게 만들수 있습니다. public interface AccountRepository extends JpaRepository<Account, Long> { boolean existsByEmail(Email email); boolean exsistByxxx(...) long countByEmail(Email email); long countByxxx(...) } 유사한 쿼리가 필요해지면 쿼리 메서드를 지속적으로 추가해야 하는 단점이 있습니다. 이런 경우에 QuerydslPredicateExecutor를
해당 코드는 Github를 확인해주세요. Spring Guide 1. Test 전략 가이드 2. Exception 전략 가이드 3. Domain 객체 가이드 4. 외부 API 가이드 5. Service 적절한 크기 가이드 6. Directory 가이드 패키지 구성은 크게 레이어 계층형, 도메인형 이렇게 2 가지 유형이 있다고 생각합니다. 각 유형별로 간단하게 설명하고 제 개인적인 Best Practices를
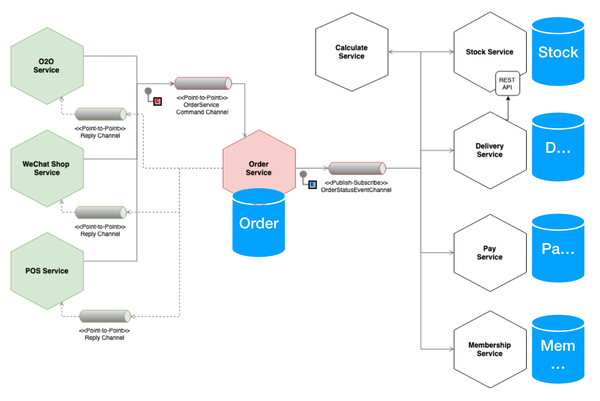
즉흥적인 글을 하나 쓰다 말고 방치해뒀는데, 이제라도 보완해서 발행한다. 꽤 시간이 지난 글에 대해 독자 한분께서 댓글을 주셨는데, 주제 특성상 하염없이 미룰 가능성이 높아 즉흥적인 생각을 풀어놓는다. 그래서, 이번 글을 김성현님 특집이라고 해도 좋을 듯 하다. 마침 오전에 있던 서비스에 대한 짧은 대화 출근하자마자 위챗으로 한 지인께서 URL 하나를 보내오셨다.
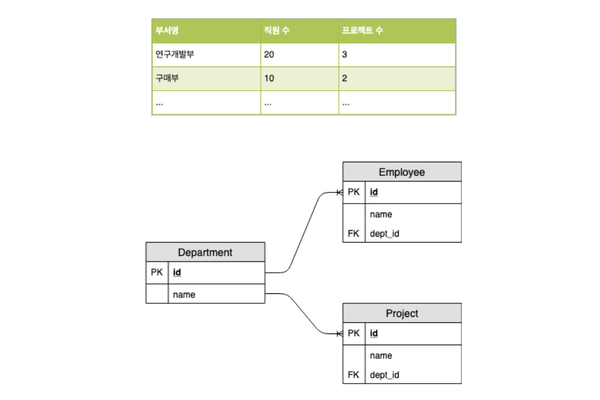
JPAJava Persistence API로 애그리게잇을 구현할 때면 흔히 루트 엔터티(전역 식별성을 지니며 주체로 쓰이는 엔터티)에 연관 엔터티 컬렉션을 매핑한다. 때때로 루트 엔터티는 연관 엔터티 컬렉션의 카운트를 제공해야 하는 경우가 있는데 여기서 성능 문제가 발생할 수 있다. 이 글은 연관 엔터티 컬렉션의 카운트를 구할 때 발생할 수 있는 성능 문제를
해당 코드는 Github에 공개되어 있습니다. 실무에서 Lombok 사용법에서 기본적인 Lombk 사용법과 Builder 사용법을 간단하게 정리 한 내용을 먼저 참고하면 좋습니다. JPA를 이용하면 엔티티 객체들을 Builder 기반으로 생성하는 것이 흔한 패턴입니다. 이러한 경우 Builder의 문제점들과 이것을 더욱 안전하게 사용하는 방법에 대해서 이야기해보겠습니다. Builder로 안전하게 생성하자 JPA 엔티티 객체들에 Builder 어노테이션을 이용해서
해당 코드는 Github를 확인해주세요. Spring Guide 1. Test 전략 가이드 2. Exception 전략 가이드 3. Domain 객체 가이드 4. 외부 API 가이드 5. Service 적절한 크기 가이드 도메인 레이어는 모든 레이어에서 사용됩니다. 이 때문에 자기 자신의 책임을 충분히 다하지 않으면 많은 영역에서 그 책임을 넘겨받게 됩니다. 이번에는 이 내용을 중심으로