Latest

Time series OLAP – Glue Architecture(5)

Time series OLAP – Glue Architecture(5)

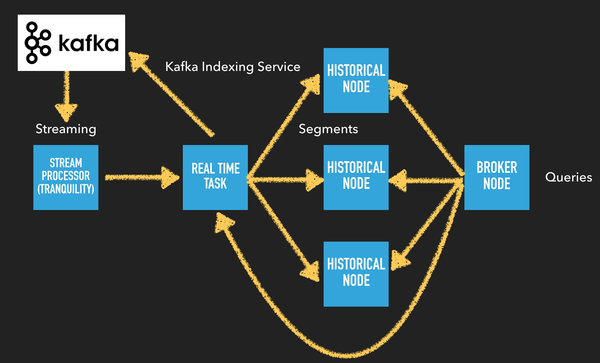
Druid - 어벤저스 계획을 세우지 못하는 것은 실패를 계획하는 것이다 - 에피존스 람다 아키텍처는 데이터 처리 아키텍처로 대용량 데이터에 대한  배치 처리와 스트림 처리 방법을 활용하여 처리하기 위해 설계된  데이터 프로세싱 아키텍처이다. 아래의 아키텍처에서 수집된 레코드는 목적에 따라 배치와 실시간 처리 시스템으로 병렬적으로 제공되고 적재된 데이터는 필요 시 데이터를 질의 할 수
By jerryjung
업그레이드를 부르는 Hadoop 3.0 신규 기능 살펴보기

업그레이드를 부르는 Hadoop 3.0 신규 기능 살펴보기

최근 아파치 하둡 홈페이지에 Hadoop 3.0.0 alpha1 도큐먼트가 공개되면서, 오픈소스 빅데이터 기술의 "아버지" 급이라 할 수 있는 하둡의 3.0 릴리즈에 대한 기대감을 더하고 있습니다.  하둡 3.0 에서 추가되는 주요 특성 및 기능들에 대해 살펴보고 사용자 관점에서 달라지는 의미를 정리해 보았습니다. Java Version 하둡 3.

By 홍 태희
개발자를 위한 맥(Mac) 정보 - 패키지관리자 Homebrew

개발자를 위한 맥(Mac) 정보 - 패키지관리자 Homebrew

개발을 할 때 꼭 맥을 사용해야하는 것은 아니지만, 주위를 살펴보면 많은 개발자 분들이 맥을 사용하고 계십니다. 필자 역시 2009년 이후 개발을 할 때 맥을 사용하고 있는데 성능이나 해상도 그리고 안정성 측면 등등에서 매우 만족하며 사용을 하고 있습니다. 앞으로 개발자를 위한 맥(Mac) 정보 제공의 관점에서 도움이 될 수 있는 내용들을

By 홍 태희
Presto 사용자 정의 함수 만들기

Presto 사용자 정의 함수 만들기

Presto는 SQL on Hadoop 계열의 오픈소스 솔루션으로 Facebook 에서 개발하였으며, 현재 Netflix 등에서 사용되고 있는 솔루션입니다. 분산된 서버에서 실행되며 SQL 처리 중 발생하는 중간 데이터는 메모리 기반으로 처리함으로써 기존 Hive on MR 보다 아주 빠른 성능으로 SQL을 처리할 수 있습니다. 또한 다양한 스토리지에 저장된 데이터를 SQL을 이용하여 Join 할 수

By 김형준
Standby NameNode 실행하기

Standby NameNode 실행하기

Hadoop에서 이중화 구성으로 운영하는 도중 Standby NameNode 등에 문제가 발생하여 새로운 서버로 교체해야 하거나, 디스크를 아예 교체해야 하는 상황이 발생할 수 있습니다.  Hadoop NameNode 이중화 구성 시 장애에 대한 내용은 다음글 참고하세요. * Hadoop NameNode 이중화 시 fencing의 역할 이렇게 새로운 하드웨어 또는 디스크에 Standby NameNode를 다음과 같은 명령으로 실행하면 예외가

By 김형준
Kafka Python client 성능 테스트

Kafka Python client 성능 테스트

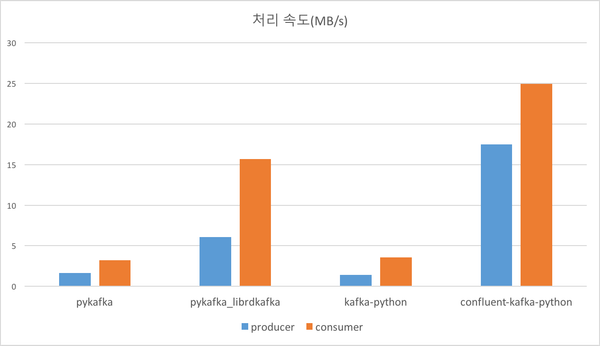
Kafka는 최근 비동기 시스템 구축이나 대용량 데이터 수집을 위해 반드시 필요한 시스템이 되었다. Python은 빅데이터 처리를 위해 많이 사용되는 언어이기 때문에 Kafka의 데이터를 처리하기 위해 Kafka Python 클라이언트도 많이 사용한다. 다음 기사는 여러 종류의 Kafka Python client 성능 테스트에 대한 결과이다. Python 사용자라면 결과에 관심을 가져볼만 하다. http://activisiongamescience.github.

By 김형준
Devstack을 활용한 오픈스택 설치하기

Devstack을 활용한 오픈스택 설치하기

오픈스택은 초기 개발자나 사용자가 활용하기에는 상당히 진입장벽이 높은 시스템입니다. 그건 아마도 리눅스 시스템, 가상화, 스토리지, 네트워크 등을 모두 어느 정도 이해해야 하기 때문이라고 생각이 듭니다. 이런 복잡한 시스템을 그나마 쉽게 접근하기 위해서는 먼저 자동으로 설치하여 어떻게 동작하는지를 이해하는 것이 좋습니다. 오픈스택에서는 devstack 이라는 프로젝트를 통해서 오픈스택의 프로젝트들을 all in one

By Seungkyu Ahn
InfluxDB, Telegraf, Grafana 를 활용한 Monitoring System 만들기(3)

InfluxDB, Telegraf, Grafana 를 활용한 Monitoring System 만들기(3)

저장소 설치 및 메트릭 수집에 이어서 세번째로 Grafana를 이용하여 대시보드를 디자인하고 시각화하는 부분에 대한 포스팅입니다. Grafana는 인기가 많은 툴이라 들어보셨거나 이미 쓰고 있는 분들도 많을 듯 한데요. InfluxDB와 마찬가지로 Grafana 또한 사용자의 니즈를 적극 반영하면서 활발히 성장하고 있고 최근에는 3.0으로 업데이트 되었습니다. 3.0으로 업데이트 되면서 큰 변화가 있었는데

By 유 승민
Time series OLAP – Druid Segment(4)

Time series OLAP – Druid Segment(4)

Druid - 새로운 희망 서투른 장인은 항상 연장 나무란다. A bad workman always blame his tools. (속담) 앞선 시리즈에서 자주 언급되었던 Druid의 저장 단위인 Segment와 Druid에서 지원하는 Query에 대해 다루려고 한다. Segment는 Druid의 time기준으로 저장되는 indexing 파일 단위를 의미하며 저장 단위는 사용자 쿼리에 따라 최적화가 가능하다. 저장하려고 하는 데이터의 수집시 indexing

By jerryjung
글라발라이제이션 - 문자 세트 및 인코딩

글라발라이제이션 - 문자 세트 및 인코딩

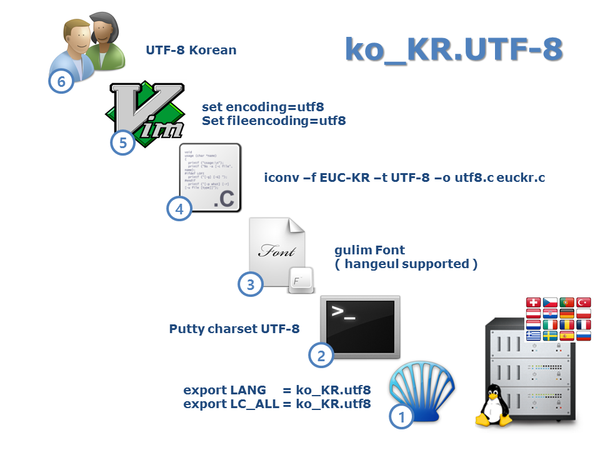
컴퓨터는 미국이 만들었다!! ASCII 는 쉽다!! 그러나, 우린 한국인이다!! ㅠㅠ 영어는 LTR 이다!! 한국어도 LTR 이다!! 그러나, 난 영어를 못한다!! ㅠㅠ 그런데, 나보고 RTL 을 지원하라고 한다?! ㅠㅠ http://en.wikipedia.org/wiki/Bi-directional_text 0. 글로발제이션!! 우리는 영어권이 아님에도 불구하고, 저를 포함해서 많은 개발분들이 i18n 이슈에 대해서 잘

By sql2