golang으로 만나보는 Duck Typing
Duck Typing ( 이하 덕 타이핑) 이란 방식이 세상에 알려진지는 상당한 시간이 지났다. 이미 덕 타이핑을 이해하고 덕 타이핑 동작 방식을 수용한 Program Language 를 도입하여 사용하는 이들도 있지만 아직까지 덕 타이핑이 무엇인지 모르는 분들이 주위에 상당하기에 이 글을 통해서 덕 타이핑에 대한 개념과 Golang 기반 Example Code를 작성하여 이해를 돕고자
 Pop your eXperience. Share It.
Duck Typing ( 이하 덕 타이핑) 이란 방식이 세상에 알려진지는 상당한 시간이 지났다. 이미 덕 타이핑을 이해하고 덕 타이핑 동작 방식을 수용한 Program Language 를 도입하여 사용하는 이들도 있지만 아직까지 덕 타이핑이 무엇인지 모르는 분들이 주위에 상당하기에 이 글을 통해서 덕 타이핑에 대한 개념과 Golang 기반 Example Code를 작성하여 이해를 돕고자
주로 엑셀로 데이터를 분석하시는 분들을 위한 작은 정보를 공유드리려고 합니다. 저는 불과 얼마 전까지 엑셀에서 조회할 수 있는 데이터 양이 1,048,576 열이라고 알고 있었습니다. 확인해본 결과, 이것은 어떤 경우엔 사실이지만 어떤 경우에는 사실이 아니었습니다. Office 2010 에서는 파워피봇(PowerPivot) 이라는 애드인(Add-In)을 설치할 수 있고, 설치
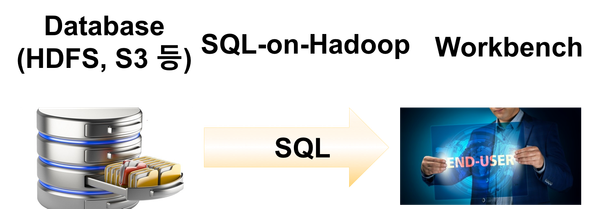
최근 데이터 저장, 처리 관련 다양한 솔루션과 오픈 소스가 나타나면서 다양한 모습으로 데이터 처리 시스템을 구축할 수 있게 되었다. 이번 글에서는 6개월 정도 작업을 통해 현재 운영 중인 서비스에 적용한 Presto, Zeppelin를 이용하여 간단한 BI 체계를 구축했던 경험에 대해 공유하고자 한다. 이 글은 두 개의 글로 구성되어 있으며 첫 번째
먼저 이 글은 텐서플로우 문서에 있는 내용의 요약본이라고 생각하시면 정확합니다. 저는 우분투 14에서 텐서플로우 사용 중이였었는데 이상하게 시스템이 불안했습니다. 정확한 진단없이 드라이버 문제라고 생각하고 그래픽 드라이버 업데이트를 시도하다가 무한 부팅 대마왕을 만나게 되었고 그 결과 제 리눅스 데스크탑을 몇 개월간 고이 모셔두게 되었습니다. 하지만 페친님 도움으로 우분투 16에서 호환성이 더
마이크로서비스 아키텍처 마이크로서비스 아키텍처는 하나의 큰 애플리케이션을 여러 개의 작은 애플리케이션으로 쪼개어 변경과 조합이 가능하도록 만든 아키텍처를 말합니다. 애플리케이션을 특화된 기능별로 나누게 되면 자연스럽게 애플리케이션의 추상화(abstraction)가 가능해집니다. 다시 말해, ‘인증’을 담당하는 서비스(예, auth.example.com)는 그 구체적인 구현 내용을 모르더라도 다른 서비스에서 약속된 인터페이스를 이용해
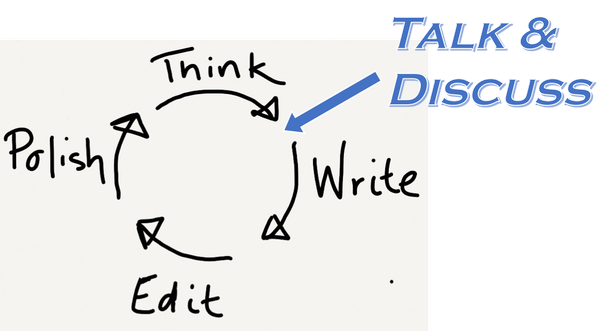
최근에 들어 실력과 경험은 많지만 자신의 실력을 오로지 자신의 운영하는 서비스나 회사에만 불사르고 계신 개발자 분들에게 경험, 기술을 공유해보라고 설파하고 있습니다. 넘사벽 수준으로 글을 잘 쓰시는 개발자 분들도 많이 있지만 반대로 자신의 지식, 경험을 글로 표현하는데 어려움을 겪고 있는 개발자 분들 많이 있습니다. 스스로 평가해보면저도 그렇게 글을 잘 쓰는 편은
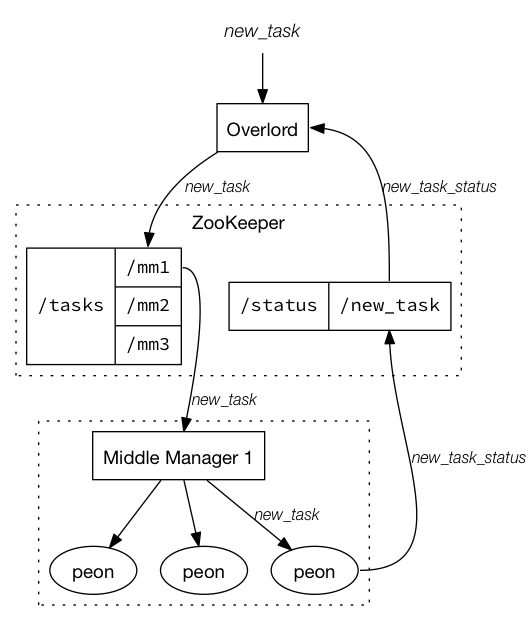
Druid 의 불꽃 전쟁의 서막을 못보셨다면 1편부터 시작 ^^ ::: Druid 입문 당신은 지체할 수도 있지만 시간은 그러지 않을 것이다. - 벤자민 프랭클린 Druid에서 실시간 처리 방식에는 Stream Push방식과 Stream Pull방식이 있다. [참고 : http://druid.io/docs/latest/ingestion/stream-ingestion.html] 실시간 처리 소개 전에 Indexing service에 대해 잠깐 짚고 넘어가자면 다음과
웹개발을 하다보면 전체 페이지를 다시 로딩하지 않고 부분적으로 내용을 업데이트 해야할 일이 많이 생깁니다. Front-end 의 MVC framework를 쓰는 경우가 아니라면 보통 이런 상황에서 Jqeury 의 Ajax 기능을 생각하게 되는데요, 이번 글에서는 이 기능을 좀 더 세련된 rails 방식으로 구현하는 법을 소개해드릴까 합니다. 예를 들어서 페이지 내에 한 부분에서
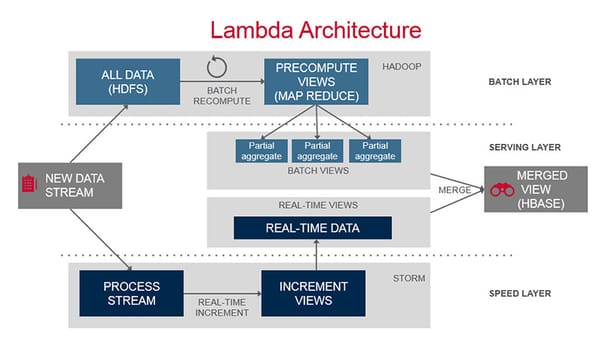
최근 하둡(Hadoop)을 중심으로한 오픈소스 빅데이터 플랫폼들의 동향을 살펴보면, Lamda Architecture 로 대변되는 실시간 데이터수집, 처리, 저장, 저장된 데이터의 배치처리, 처리된 데이터의 조회(분산 데이터베이스)의 각 영역에 기술적으로 성숙했다고 볼 수 있는 굵직굵직한 플랫폼들이 이미 자리를 잡은 모습입니다. (이미지:http://www.mapr.com/sites/default/files/otherpageimages/lambda-
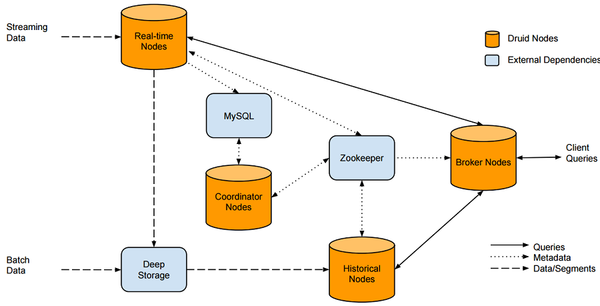
Druid - 전쟁의 서막 때는 찬바람 불어 호빵을 호호 불며 우물거리던 작년 겨울 Business Problems 쉴틈도 없이 마구마구 뿜어내는 time series 데이터를 어떻게 효율적으로 처리할까라는 고민에서 시작되었다. 빅데이터에는 수많은 오픈소스 기술셋이 존재한다. 적합한 오픈소스는? [참고 : http://xyz.insightdataengineering.com/blog/pipeline_map.html ] Solution 비지니스 요건중에 time series 데이터에 대한 통계를
이번 글에서는 Java8 Stream의 parallel에 대해 살펴보도록 하겠습니다. Stream API는 설계 시 실제 실행에 대한 부분을 추상화 시켜 각 Element에 대한 처리가 어떻게 실행되는지에 대해서는 프로그래머는 신경쓰지 않이도 된다. 즉, 병렬 처리 등도 쉽게 할 수 있게 설계되어 있다. 하지만 쉽다는 의미는 좋다, 효과적이다 라고 할 수 없기 때문에 Stream에서