
logstash 필터 dissect 성능 테스트
방화벽처럼 key-value 구조가 반복되는 로그의 필드 분류에는 kv 필터가 딱이다. 특히 구분기호로 '='을 사용하는 key-value 구조는 kv {} 구문만으로도 완벽한 테이블 구조를 만들어 줌.
sip = 1.1.1.1 dip = 2.2.2.2 sport = 100 dport = 200 action = permit
sip = 1.1.1.1 dip = 2.2.2.2 sport = 100 dport = 200 action = permit
sip = 1.1.1.1 dip = 2.2.2.2 sport = 100 dport = 200 attack = 10.10.10.10
sip = 1.1.1.1 dip = 2.2.2.2 attack = 10.10.10.10
sip = 1.1.1.1 dip = 2.2.2.2 sport = 100 dport = 200 action = permit
sip = 1.1.1.1 dip = 2.2.2.2 sport = 100 dport = 200 attack = 10.10.10.10
sip = 1.1.1.1 dip = 2.2.2.2 attack = 10.10.10.10
sip = 1.1.1.1 dip = 2.2.2.2 sport = 100 dport = 200 action = permit
sip = 1.1.1.1 dip = 2.2.2.2 sport = 100 dport = 200 attack = 10.10.10.10
sip = 1.1.1.1 dip = 2.2.2.2 attack = 10.10.10.10
문제는 kv 필터가 내부적으로 정규표현식을 사용한다는 것. 성능 저하가 발생할 수 있다는 얘기. 이때 dissect 필터가 대안이 될 수 있다. dissect는 데이터 전체에 반영된 공통된 구조를 그대로 이용해서 원하는 부분을 잘라내는 기능을 제공하며, 로그는 보통 사람 읽기 좋으라고 띄어쓰기를 하기 때문에 '공백' 구조를 많이 활용한다. 로그 구조가 다음과 같을 때
sip = 1.1.1.1 dip = 2.2.2.2 attack = 10.10.10.10다음 필터식을 이용하면
dissect {
 mapping => {
  "message" => "%{} = %{sip} %{} = %{dip} %{} = %{attack}"
 }
}
다음과 같은 테이블 구조를 만들 수 있다. %{} 구문은 데이터 검사만 하고, %{sip} 구문은 검사 결과를 sip 필드에 저장.
{
 "sip":"1.1.1.1"
 "dip": 2.2.2.2"
 "attack":"10.10.10.10"
}
데이터가 key-value 구조라면 더 효율적으로 테이블 구조를 만들 수도 있다. %{?same_name}구분기호%{&same_name} 구문을 사용하면 '구분기호'를 기준으로 앞에 있는 %{?same_name} 구문은 key, 뒤에 있는 %{&same_name} 구문은 value로 저장.
input {
file {
path => "D:/test.log"
start_position => "beginning"
sincedb_path => "nul"
}
}
filter {
#kv {}
ruby {
code => "event.set('field_count', event.get('message').split('=').count() - 1)"
}
if [field_count] == 5 {
dissect {
mapping => {
"message" => "%{?1} = %{&1} %{?2} = %{&2} %{?3} = %{&3} %{?4} = %{&4} %{?5} = %{&5}"
}
}
} else {
dissect {
mapping => {
"message" => "%{?1} = %{&1} %{?2} = %{&2} %{?3} = %{&3}"
}
}
}
}
output {
file {
path => "d:/test-dissect.log"
}
}
kv처럼 유연한 처리는 어렵기 때문에 ruby 필터를 이용해서 필드 개수를 파악, 들쭉날쭉 변하는 필드 개수에 대응했다. 참고로 로그스태시가 드디어 숫자를 인식한다. [field_count] == "5" 구문 안 먹더라. 버전 7부터 바뀐 건가?
I7(4코어), SSD 환경에서 kv 필터를 사용했을 때 로그 백만 개 연동에 22초 소요. 약 45,000 eps.
dissect 필터는 18초 소요. 약 55,000 eps.
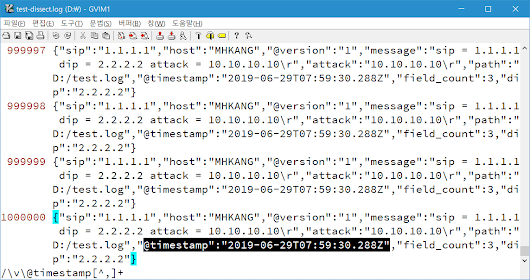
몇 번 반복해본 결과 대략 2~30% 정도, 많게는 40% 까지도 성능이 향상된다.



