Presto 사용자 정의 함수 만들기
Presto는 SQL on Hadoop 계열의 오픈소스 솔루션으로 Facebook 에서 개발하였으며, 현재 Netflix 등에서 사용되고 있는 솔루션입니다. 분산된 서버에서 실행되며 SQL 처리 중 발생하는 중간 데이터는 메모리 기반으로 처리함으로써 기존 Hive on MR 보다 아주 빠른 성능으로 SQL을 처리할 수 있습니다. 또한 다양한 스토리지에 저장된 데이터를 SQL을 이용하여 Join 할 수
 Pop your eXperience. Share It.
Presto는 SQL on Hadoop 계열의 오픈소스 솔루션으로 Facebook 에서 개발하였으며, 현재 Netflix 등에서 사용되고 있는 솔루션입니다. 분산된 서버에서 실행되며 SQL 처리 중 발생하는 중간 데이터는 메모리 기반으로 처리함으로써 기존 Hive on MR 보다 아주 빠른 성능으로 SQL을 처리할 수 있습니다. 또한 다양한 스토리지에 저장된 데이터를 SQL을 이용하여 Join 할 수
Hive 를 사용하다 보면 아래 로그와 같이 Hive 의 Metastore 에 버전이 여러 개 존재한다고 하는 MetaException(message:Metastore contains multiple versions) 에러를 종종 만나게 됩니다. 아래 로그는 실제 에러가 발생한 이후, Hive 를 통하여 어떠한 쿼리를 실행하였을 때 발생하는 에러 로그 입니다. 2016-07-02 16:14:33,330
Hadoop에서 이중화 구성으로 운영하는 도중 Standby NameNode 등에 문제가 발생하여 새로운 서버로 교체해야 하거나, 디스크를 아예 교체해야 하는 상황이 발생할 수 있습니다. Hadoop NameNode 이중화 구성 시 장애에 대한 내용은 다음글 참고하세요. * Hadoop NameNode 이중화 시 fencing의 역할 이렇게 새로운 하드웨어 또는 디스크에 Standby NameNode를 다음과 같은 명령으로 실행하면 예외가
아재 연배가 되다 보니 의도하지 않게 최근 몇년 동안은 채용을 위해 개발자의 면접관으로 참석하는 일이 많아 지고 있습니다. 면접관마다 지원자를 보는 관점과 방식은 다르겠지만 이 글에서는 제가 개발자 인터뷰를 진행할 때 주로 묻는 질문과 어떤 관점을 중점적으로 보는지 정리해보려고 합니다. 최근 제 지인분들도 인터뷰를 많이 다니고 계신데 한군데 오래 계신
미미미!! 밍밍밍!! 미미미!! 밍밍밍!! https://www.youtube.com/watch?v=qmaBi7FABxE 0. X Windows for Amazon Linux AMI 다음은 AWS EC2 ( Elastic Compute Cloud ) 인스턴스 Amazon Linux AMI ( Amazon Machine Image ) 에서 GUI 를 활용하기 위해서 X Window 를 실행하는 하기 위해서 최소한의 설치와 설정을 소개합니다. 일반적으로 X Windows 설치
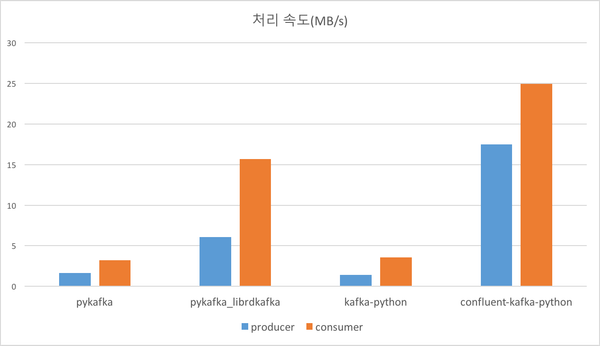
Kafka는 최근 비동기 시스템 구축이나 대용량 데이터 수집을 위해 반드시 필요한 시스템이 되었다. Python은 빅데이터 처리를 위해 많이 사용되는 언어이기 때문에 Kafka의 데이터를 처리하기 위해 Kafka Python 클라이언트도 많이 사용한다. 다음 기사는 여러 종류의 Kafka Python client 성능 테스트에 대한 결과이다. Python 사용자라면 결과에 관심을 가져볼만 하다. http://activisiongamescience.github.
Java
예전엔 정말로 통계/생물과에서는 R, 공대생은 Matlab, 공장이나 은행은 SAS, 경영학과는 Excel, 수학 관련은 Mathmatica라는 선입견이 있었습니다. 물론 Stata나 SPSS등 다른 툴을 선호하시는 분도 많았고 linux와 같이 소개된 Octave가 점차 널리 쓰이기도 하면서 실제로는 더 많은 종류의 툴들이 공존하고 있었는데, 어찌보면 비효율적일 수도 있고 어찌보면 하나의 범용적인 툴보다 각자 더
오픈스택은 초기 개발자나 사용자가 활용하기에는 상당히 진입장벽이 높은 시스템입니다. 그건 아마도 리눅스 시스템, 가상화, 스토리지, 네트워크 등을 모두 어느 정도 이해해야 하기 때문이라고 생각이 듭니다. 이런 복잡한 시스템을 그나마 쉽게 접근하기 위해서는 먼저 자동으로 설치하여 어떻게 동작하는지를 이해하는 것이 좋습니다. 오픈스택에서는 devstack 이라는 프로젝트를 통해서 오픈스택의 프로젝트들을 all in one
저장소 설치 및 메트릭 수집에 이어서 세번째로 Grafana를 이용하여 대시보드를 디자인하고 시각화하는 부분에 대한 포스팅입니다. Grafana는 인기가 많은 툴이라 들어보셨거나 이미 쓰고 있는 분들도 많을 듯 한데요. InfluxDB와 마찬가지로 Grafana 또한 사용자의 니즈를 적극 반영하면서 활발히 성장하고 있고 최근에는 3.0으로 업데이트 되었습니다. 3.0으로 업데이트 되면서 큰 변화가 있었는데
Facebook Insight
이번 글에서는 Popit 서비스의 페이스북 페이지(https://www.facebook.com/popitkr)를 운영하면서 사용했던 페이스북 인사이트 기능 및 Post의 세부 지표를 보는 방법에 대해 살펴보겠습니다. 페이스북 Page 는 최근 가장 중요한 마케팅 수단으로 떠 올랐습니다. Popit 서비스도 페이스북 페이지와 페이스북이 없었더라면 초기에 사용자에게 컨텐츠를 노출시키는데 한계가 있었을 것입니다. 과거에는 주로
Druid - 새로운 희망 서투른 장인은 항상 연장 나무란다. A bad workman always blame his tools. (속담) 앞선 시리즈에서 자주 언급되었던 Druid의 저장 단위인 Segment와 Druid에서 지원하는 Query에 대해 다루려고 한다. Segment는 Druid의 time기준으로 저장되는 indexing 파일 단위를 의미하며 저장 단위는 사용자 쿼리에 따라 최적화가 가능하다. 저장하려고 하는 데이터의 수집시 indexing
직장인 3년차쯤 되면 동기들과 실력의 차를 실감하며 고민에 빠진다. 자신의 전문성이 다른 동료들과 뒤쳐져 있거나 혹은 어떤 전문성을 키워갈지 조차도 정하지 못해 한숨이 새어나오기도 한다. 그래서 직장인 3년차 징크스라고들 한다. 하루라도 빨리 직장에서 직업을 찾고 그 분야에 몰입한다면 100세 시대에 오래도록 즐겁고 재미지게 잘할 수 있는 일에 더욱 에너지를 쏟을