Latest

아파치 실시간 처리 프레임워크 비교분석 (1)

아파치 실시간 처리 프레임워크 비교분석 (1)

최근 실시간 처리를 위한 다양한 프레임워크가 오픈되어 있는데, 각 프레웜워크의 특성과 장단점을 비교해 보려고 합니다(원문 : cakesolution.net ). 실시간 분산 처리 프레임워크는, DAGs(Directed Acyclic Graphs)라 불리우는 데이터 처리 모델을 바탕으로, 수초(혹은 ms) 이내에 무한한 데이터의 처리, 집계, 분석을 할 수 있습니다. DAG는 아래 그림에서 볼 수 있듯이
By 홍 태희
Hadoop NameNode  이중화 시 fencing의 역할

Hadoop NameNode 이중화 시 fencing의 역할

Bigdata 시스템을 구축한 대부분의 회사나 조직에서는 Hadoop 중 파일 시스템에 해당하는 HDFS(Hadoop Distributed File System) 를 기본 데이터 저장소로 활용하고 있습니다. HDFS는 Bigdata 시스템의 가장 기초부분이라고 할 수 있습니다. 이런 시스템이 장애라도 발생하면 모든 분석 업무가 중단될 가능성이 많습니다. HDFS에 저장된 데이터의 규모도 엄청 크기 때문에 HDFS 클러스터 자체를

By 김형준
WordPress Plugin 살펴보기 : Crayon Syntax Highlighter

WordPress Plugin 살펴보기 : Crayon Syntax Highlighter

기술 블로그를 쓸 때 가장 중요한 부분 중에 하나가 Code Highliter 가 아닐까 싶습니다. 아직 WordPress 에 있는 많은 플러그인들을 다 보지는 못했지만, 시간이 나는대로 유용한 플러그인 들을 좀 살펴보려 하는데, 먼저 현재 사용중인 Crayon Syntax Highliter 를 살펴보겠습니다. . 글을 작성하는 시점에 50,000+ 활성 설치에 평가도 별5개로 매우 우수합니다.

By 홍 태희
Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(2)

Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(2)

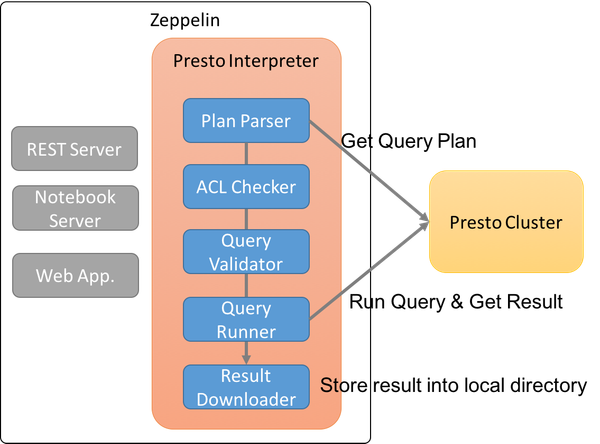
이번 글은  "Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(1)" 에 대한 세부 기술적인 내용에 대한 글입니다. 지난 글에서는 사용자들의 요청사항을 기반으로 Presto, Zeppelin을 이용하여 대용량 데이터를 분석할 때 사용자가 직접 SQL을 사용할 수 있는 시스템을 만든 이유와 솔루션 선정에 대해 설명하였습니다. 첫번째 글와 이번 글은 다음

By 김형준

Rspec, SQLite3와 Fixture를 이용한 Rails API 테스트

어떤 산업군에서든지 퀄리티가 좋은 제품을 생산한다는 것은 어쩌면 얼마나 견고한 테스트를 거쳤냐는 것을 뜻하는 것일 수 있습니다. 시간과 인력이 부족하다는 이유로 테스트를 경미하게 생각하거나, 이를 무시하고 출시하고 나서 나중에 예상치 못한 결함으로 오히려 더 큰 시간적 재무적인 손실을 보게 되는 경우를 종종 접하게 됩니다 . 웹/앱, API등의 소프트웨어를 만드는 일도

By kalia
Time series OLAP – Druid Batch Ingestion(3)

Time series OLAP – Druid Batch Ingestion(3)

Druid - 보이지 않는 위험 위험을 피하려면 최악의 사태를 항상 대비해 두어야 한다. - 그라시안 필자의 경우 Batch Ingestion에서 많은 고통을 느꼈다 ㅠㅠ Druid를 적용하는 케이스가 실시간쪽보다는 배치쪽인 경우가 다수였으며 Batch 의 경우, Druid와의 싸움(?)보다는 MR job에 의존도가 크기에 문제 해결에 상당히 많은 시간이 소요되었다. 혹시나 같은 고통을 겪으실 누군가에게 이

By jerryjung

golang으로 만나보는 Duck Typing

Duck Typing ( 이하 덕 타이핑) 이란 방식이 세상에 알려진지는 상당한 시간이 지났다.  이미 덕 타이핑을 이해하고 덕 타이핑 동작 방식을 수용한 Program Language 를 도입하여 사용하는 이들도 있지만 아직까지 덕 타이핑이 무엇인지 모르는 분들이 주위에 상당하기에 이 글을 통해서  덕 타이핑에 대한 개념과 Golang 기반 Example Code를 작성하여 이해를 돕고자

By 심 천보
파워피봇으로 엑셀(Excel) 데이터 분석의 날개를 달자

파워피봇으로 엑셀(Excel) 데이터 분석의 날개를 달자

주로 엑셀로 데이터를 분석하시는 분들을 위한 작은 정보를 공유드리려고 합니다. 저는 불과 얼마 전까지 엑셀에서 조회할 수 있는 데이터 양이 1,048,576 열이라고 알고 있었습니다. 확인해본 결과, 이것은 어떤 경우엔 사실이지만 어떤 경우에는 사실이 아니었습니다. Office 2010 에서는 파워피봇(PowerPivot) 이라는 애드인(Add-In)을 설치할 수 있고, 설치

By 홍 태희
Akka stream 을 활용한 reliable message stream 처리

Akka stream 을 활용한 reliable message stream 처리

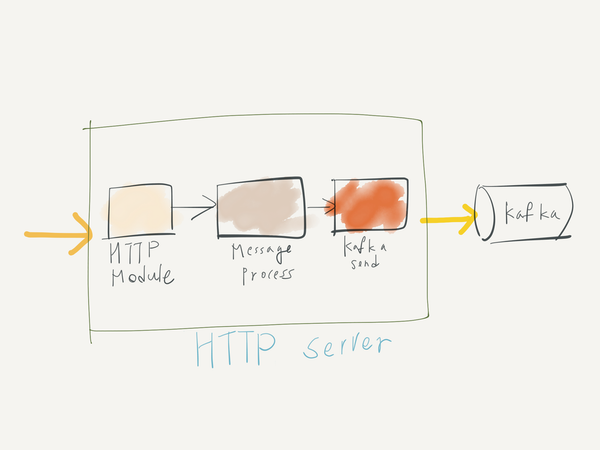
이번에 정리하고자 하는 내용은 Akka stream을 사용할 때 message 손실의 위험을 줄일 수 있는 방법입니다. 그럼, Akka에 대해 먼저 간략히 정리해보도록 하겠습니다.  Akka에 대해서는 다른 많은 블로그와 다양한 자료에서 익히 설명하고 있으므로, 간단히 개념만 훑어본 후 실제로 Akka stream을 활용하는 방법을 집중적으로 설명하겠습니다. Akka Akka는 Actor 를 근간으로 하는 high

By junkikim
Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(1)

Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(1)

최근 데이터 저장, 처리 관련 다양한 솔루션과 오픈 소스가 나타나면서 다양한 모습으로 데이터 처리 시스템을 구축할 수 있게 되었다. 이번 글에서는 6개월 정도 작업을 통해 현재 운영 중인 서비스에 적용한 Presto, Zeppelin를 이용하여 간단한 BI 체계를 구축했던 경험에 대해 공유하고자 한다. 이 글은 두 개의 글로 구성되어 있으며 첫 번째

By 김형준
Tensorflow 설치하기 (Ubuntu 16)

Tensorflow 설치하기 (Ubuntu 16)

먼저 이 글은 텐서플로우 문서에 있는 내용의 요약본이라고 생각하시면 정확합니다. 저는 우분투 14에서 텐서플로우 사용 중이였었는데 이상하게 시스템이 불안했습니다.  정확한 진단없이 드라이버 문제라고 생각하고 그래픽 드라이버 업데이트를 시도하다가 무한 부팅 대마왕을 만나게 되었고 그 결과 제 리눅스 데스크탑을 몇 개월간 고이 모셔두게 되었습니다. 하지만 페친님 도움으로 우분투 16에서 호환성이 더

By Donam Kim