엘라스틱 키워드 필드의 ignore_above
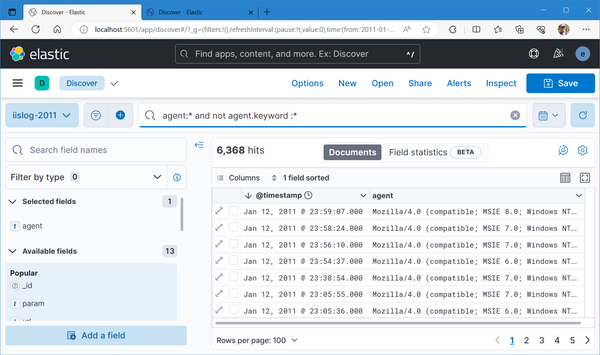
로그스태시를 이용한 데이터 연동 시 문자열 데이터는 형태소 단위로 인덱싱하는 text 타입과 집계 정렬 목적으로 인덱싱을 하지 않는 keyword 타입, 2개의 필드에 저장된다.이때 keyword 타입 필드는 ignore_above 값(기본값은 256)보다 길이가 긴 데이터를 저장하지 않는다고 한다. 실제 text와 keyword 필드를 비교해보니 저장 결과가 다른 상황 발생. ignore_
 Pop your eXperience. Share It.
로그스태시를 이용한 데이터 연동 시 문자열 데이터는 형태소 단위로 인덱싱하는 text 타입과 집계 정렬 목적으로 인덱싱을 하지 않는 keyword 타입, 2개의 필드에 저장된다.이때 keyword 타입 필드는 ignore_above 값(기본값은 256)보다 길이가 긴 데이터를 저장하지 않는다고 한다. 실제 text와 keyword 필드를 비교해보니 저장 결과가 다른 상황 발생. ignore_
검색엔진은 잘 모르지만 엘라스틱을 데이터 분석툴로 사용할 때 데이터 전처리가 차지하는 비중은 생각보다 크다. 그렇다 보니 자연스럽게 로그스태시 필터 기능을 소개하는 데 많은 시간을 할애한다. 그때 종종 받는 (툴을 잘 쓰면 데이터 분석이 쉬워질거라는 기대가 담긴) 질문. 저 기능들을 언제 다 익혔나요? 그러게? 난 언제 저 기능들을 익혔지? 사실은 익힌
엘라스틱 머신러닝이 7.6 버전부터 지도학습(supervised learning)을 지원한다. 얼마나 잘 동작하는지 IDS 로그에 적용해보자. 다음 글을 참고했다. * 새로 나온 이 영화 재미있을까? 학습 데이터는 1로 라벨링된 887개의 정탐과 0으로 라벨링된 6,700여 개의 오탐이 섞인 제일 만만한 sql injection 탐지 로그. 정탐 오탐 모델 학습 학습 데이터를 sqland-

elasticsearch
특정 작업의 생성부터 소멸까지의 수명 주기가 jobID라는 식별자로 구분되는 로그가 있다. 하나의 작업에 소요된 시간을 구해보자. 마지막 작업이 실행된 시간에서 최초 작업 실행 시간을 빼면 된다. [08:00:37.410] SendJob(jobID:75343414529) [08:00:39.235] SendReport(jobID:75343414529) 근데 어떻게 하지? 가장 간단한 방법은 서로 다른 시점에 발생한
elasticsearch
작년 11월말 탈고 후, 전자책 출간을 알아보기 시작했다. 전자책을 선택한 가장 큰 이유는 책에 포함된 50여 개의 외부 참조 URL 때문. 종이책으로 내면 URL 타이핑하다 열 받을 독자들이 눈에 밟혔다. 출판사와의 밀당도 지겹고. 1. 전자책 플랫폼 선택 좀 알아본 결과 처음 점찍었던 아마존은 탈락. 한글과 pdf 출판을 지원하지 않는다. 구글링해보면
저번 포스팅에서는 라라벨 프레임워크 - 엘라스틱서치 사용 경험기 1편을 통해 엘라스틱서치를 사용하는 데 필요한 초기 작업에 대해 알아봤다. 주로 라라벨 프레임워크와 엘라스틱서치의 연동 그리고 기존의 데이터를 엘라스틱서치의 문서로 색인하는 작업을 진행했는데 오늘은 1편에 이어서 엘라스틱서치를 사용하면서 필요한 문서 관리 작업 수행에 대한 포스팅을 작성하고자 한다. 목차는 다음과 같다. 목차 * 라라벨 프레임워크
요즘에는 검색엔진으로 엘라스틱서치를 워낙 많이 사용하다 보니까 여차여차 나도 스프링, 레일즈에서 엘라스틱서치를 구축했던 경험이 있다. 이번에는 라라벨 프레임워크에서 엘라스틱서치를 사용할 기회가 생겨 그 경험을 정리하기 위해서 포스팅한다. 목차는 다음과 같이 구성되어있다. 목차 * 라라벨 프레임워크 - 엘라스틱서치 사용 경험기 : 초기 작업 수행(현재) * 라라벨 프레임워크 - 엘라스틱서치 사용 경험기 : 문서 관리 작업 수행
급변하는 날씨를 예측하려면 어떠한 정보가 있어야 할까? 또는 마트를 운영하는 담당자인 경우 매장 운영시간을 정해야 한다면 어떠한 기준으로? 뜨거운 감자인 비트코인 시장에서 수익을 얻으려면 어떤 정보들이 있어야 물리지(?) 않을수 있을까? 위 질문에 공통된 정답은 예전 기록들인것 같다. 날씨예측은 기상청에서 과거 기록들을 보고 비가 올지 말지를 결정하고 ( 과거 날씨 서비스를 담당해봤지만
elasticsearch
제목이 너무 도발적인가? 지금 이순간에도 대규모, 대용량 환경에서 성능 등의 문제로 골머리 썩는 분들에겐 죄송(..) 하지만 엘라스틱을 데이터 분석툴로 활용하는 입장에서는 쉬우니 쉽다고 할 수 밖에. 처음 접한 건 작년 여름, 데이터 분석 서비스를 제공하는 logz.io를 통해서였다. 사실 데이터 분석 분야에서 엘라스틱이라는 오픈소스가 유행이라는 얘기는 들어왔지만, IDS 등 사실
Desktop 및 스마트폰의 대중화로 다양한 OS와 브라우저들을 사용하게 되었다. 이때, 내가 운영하는 웹서버에 들어오는 사람들은 무슨 기기로 접속을 하는 것일까? 혹여 특정 OS의 특정 브라우저에서만 안되는 버그를 잡기 위해 몇일밤을 고생하며 겨우 수정했는데… 과연 그 OS의 브라우저에서는 접속은 하기나 하는걸까? (ㅠㅠ) 만약, 접속 사용자의 Device 정보를 알고있다면 고생하며 버그를 잡기
가끔 엘라스틱서치에서 특수문자를 검색하고 싶을 때가 있는데 잘 안 된다. 다음은 var 필드에서 특수문자 '='을 포함한 모든 문자열을 검사하는 '*=*'의 검색 결과. 검색 결과가 없는 이유는 엘라스틱서치가 인덱스 색인을 만드는 과정에서 특수문자를 '공백' 취급해버리기 때문. 다음은 문자열 'a=d'의 인덱싱 결과.
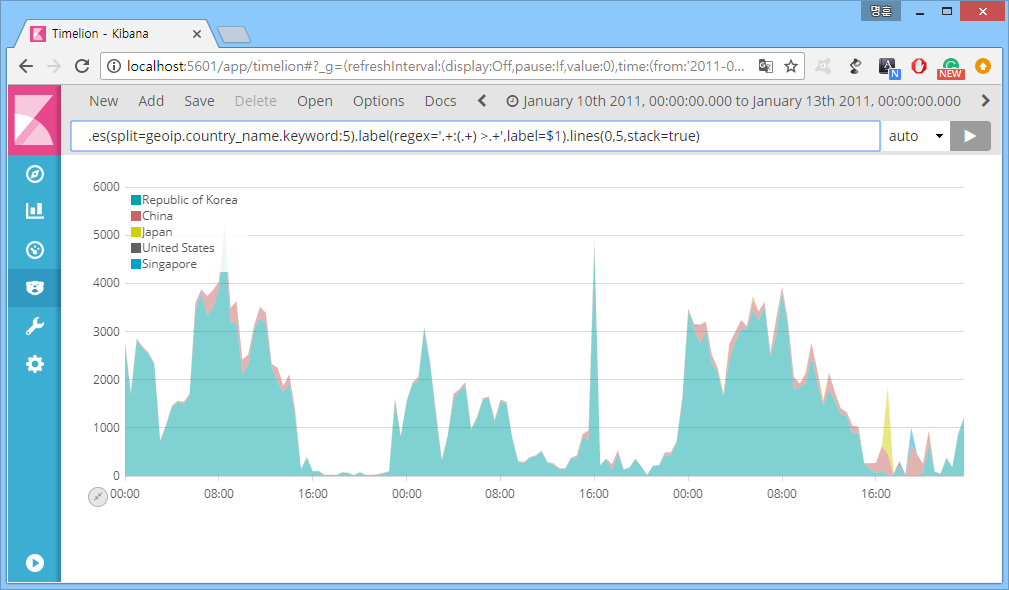
ELK 스택 삼대장 중 키바나를 개발한 '라쉬드 칸(Rashid Khan)'이 비행기 타고 가다 뚝딱 만들었다는 timelion. 이름에서 알 수 있듯이 timelion은 시계열 데이터 분석에 특화되어 있으며, 함수 형식의 표현식을 사용한다. 자동완성을 지원하기 때문에, 학습도 그리 어렵지 않은 편. 웹서버 접속자의 국가별 발생 추이를 그려보자. 다음은 상위 5개의