데이터 분석이 쉬워지는 비법
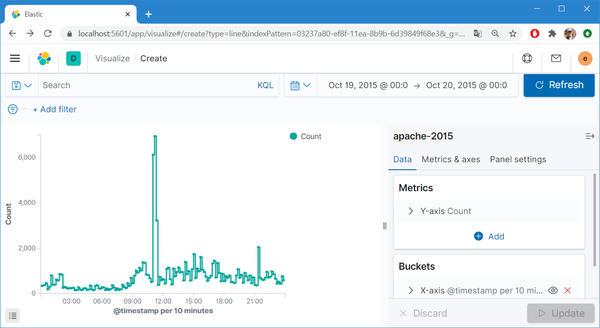
단순 카운트 변화 추이는 로그의 상태를 정확히 표현하지 못한다. 다양한 상태 정보가 섞여 있는 상태에서 개수의 변화가 어떤 상태를 특정하는지 알기 힘들다는 얘기. count 추이(12~25일) 그래서 강조하는 게 상태별 고유성 확보를 통한 데이터 해상도 변경 및 다양한 Metric 활용. 카운트 추이로는 알 수 없었던 19일의 상태 변화가 해상도
 Pop your eXperience. Share It.
데이터 분석 관점의 로그 분석 분야에 관심 많습니다.
단순 카운트 변화 추이는 로그의 상태를 정확히 표현하지 못한다. 다양한 상태 정보가 섞여 있는 상태에서 개수의 변화가 어떤 상태를 특정하는지 알기 힘들다는 얘기. count 추이(12~25일) 그래서 강조하는 게 상태별 고유성 확보를 통한 데이터 해상도 변경 및 다양한 Metric 활용. 카운트 추이로는 알 수 없었던 19일의 상태 변화가 해상도

소프트웨어 세상에서 제발 건설식 비유가 사라지면 좋겠습니다. 건설업은 시설을 중심에 놓고, 사람을 부품으로 사용하는 생산체계입니다. 매번 맨땅에서부터 시작해야 하니 그런게 이해됩니다. 하지만, 소프트웨어 세상에선 그런걸 잘했다고 돈을 더벌진 않죠. 그냥 잘팔리는 제품을 만들어야 합니다. 즉, 소프트웨어 세계에선 사람이 비용이 아니라 투자대상입니다. IT 분야에서 남다른 통찰력을 보여주는 김수보님의 최근 글. IT
엘라스틱 머신러닝이 7.6 버전부터 지도학습(supervised learning)을 지원한다. 얼마나 잘 동작하는지 IDS 로그에 적용해보자. 다음 글을 참고했다. * 새로 나온 이 영화 재미있을까? 학습 데이터는 1로 라벨링된 887개의 정탐과 0으로 라벨링된 6,700여 개의 오탐이 섞인 제일 만만한 sql injection 탐지 로그. 정탐 오탐 모델 학습 학습 데이터를 sqland-
vim
0과 1로 구분된 데이터가 있다. 그런데 이상하게 구분값 1은 0, 0은 1로 바꾸고 싶네? 치환 명령어 '%s/1$/0/'와 '%s/0$/1/'를 순서대로 실행하면 1 -> 0, 0 -> 1로 바뀔까? 첫 번째 작업에서 1이 사라지고 0만 남기 때문에, 결과적으로 마지막엔 1만 남는다. 이럴
Ruby
지난 글에서 elapsed 필터로 멀티 라인 구조를 갖는 하나의 트랜잭션 실행 시간을 구해봤는데 멀티 코어가 멀티 라인 로그를 나눠 처리하는 로그스태시의 동작 방식 때문에 잘 되지 않았다. 그렇다고 싱글 코어를 쓰자니 로그양이 너무 많고(..) test.log [08:00:37.410] StartJob [08:00:39.235] EndJob 멀티 라인 구조를 싱글

elasticsearch
특정 작업의 생성부터 소멸까지의 수명 주기가 jobID라는 식별자로 구분되는 로그가 있다. 하나의 작업에 소요된 시간을 구해보자. 마지막 작업이 실행된 시간에서 최초 작업 실행 시간을 빼면 된다. [08:00:37.410] SendJob(jobID:75343414529) [08:00:39.235] SendReport(jobID:75343414529) 근데 어떻게 하지? 가장 간단한 방법은 서로 다른 시점에 발생한
elasticsearch
작년 11월말 탈고 후, 전자책 출간을 알아보기 시작했다. 전자책을 선택한 가장 큰 이유는 책에 포함된 50여 개의 외부 참조 URL 때문. 종이책으로 내면 URL 타이핑하다 열 받을 독자들이 눈에 밟혔다. 출판사와의 밀당도 지겹고. 1. 전자책 플랫폼 선택 좀 알아본 결과 처음 점찍었던 아마존은 탈락. 한글과 pdf 출판을 지원하지 않는다. 구글링해보면
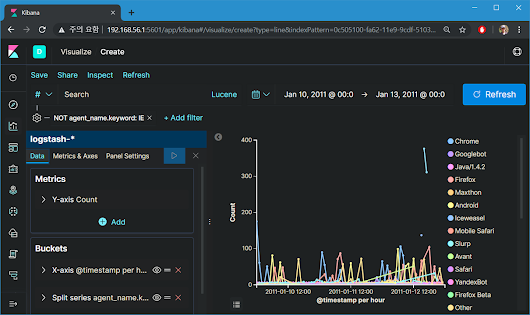
웹 요청 트래픽에는 useragent라는 웹 요청을 시도할 때 사용된 도구에 대한 정보가 있다. 이걸 분석해보겠다고 예전엔 정규표현식으로 웹 로그의 useragent 문자열을 추출한 후, 유형과 운영체제 등을 일일이 분류하는 노가다를 했었는데(..) 그런데 이걸 자동으로 분석해주는 useragent라는 필터 플러그인을 엘라스틱이 제공한다. 다음은 샘플 로그. Mozilla/4.0 (compatible; MSIE 7.0; Windows
다음은 'failed login' 메시지 조건을 이용한 로컬 로그인 실패 발생 추이. 'failed login' 메시지와 로그인 실패 발생은 양의 상관관계를 갖는다. 상관분석 사례는 없냐는 질문을 받았다. 네? 지금 하고 있는데요 담배 타임 때 슬쩍 물어봤다. 어떻게 하는 게 상관분석일까요? 로그를 2개 이상 묶어야 상관분석이라고. 사례도 하나 알려
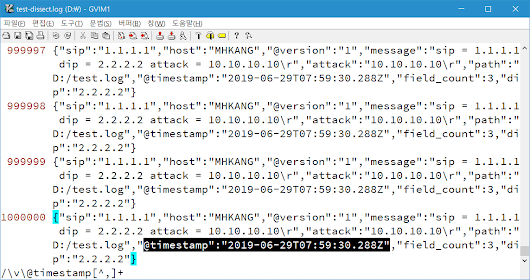
방화벽처럼 key-value 구조가 반복되는 로그의 필드 분류에는 kv 필터가 딱이다. 특히 구분기호로 '='을 사용하는 key-value 구조는 kv {} 구문만으로도 완벽한 테이블 구조를 만들어 줌. sip = 1.1.1.1 dip = 2.2.2.2 sport = 100 dport = 200 action = permit sip = 1.1.1.1 dip = 2.
엑셀
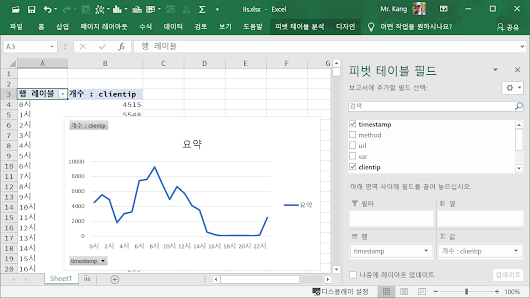
이리저리 조립과 해체를 반복하면서 데이터랑 친해지는 데 엑셀만한 게 없지. 그래서 웬만한 분석은 여전히 엑셀로 한다. 다음은 피벗 테이블을 이용한 사용자 접속 발생 추이. 시간당 최대 접속치는 9000을 넘는다. 이 수치로 알 수 있는 건 무엇일까? 한 명이 9000번 접속? 아니면 9000명이 한 번씩 접속? 해당 그래프는 접속자 ip 개수를
데이터 분석
구글 트렌드로 미국 인종차별 실체를 밝혔다가 구글에 채용됐다는 세스 스티븐스 다비도위츠의 2017년 저서. 제목에 끌려서 골랐는데 구글 검색 데이터가 사람들 예측에 유용하다는, 그리 새롭지는 않은 내용. 대신 저자 유머 코드가 나랑 좀 맞아서 지루하지 않게 읽을 수 있었다(..) 이 책은 저자가 구글 트렌드로 인종차별 지도를 그리면서 시작한다. 2008년 버락 오바마의