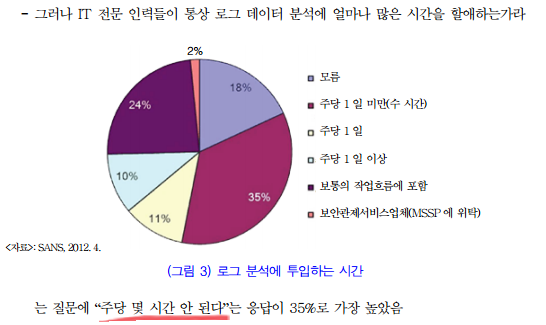
제일 쉬운 로그 분석
popit에 처음 글 올립니다. 저는 주로 IDS 등 네트워크 보안장비 로그 분석하는 일을 해왔구요. 앞으로 로그 분석이나 보안 관련된 개인적인 경험을 풀어볼까 합니다. 첫번째 주제는 '보안 분야의 로그 분석에 대한 인식'입니다. 지적 많이 해주시구요. 편의상 경어는 생략합니다. 어느 기관 강의하러 갔다가 생긴 일 좀 높으신 듯한 분과
 Pop your eXperience. Share It.
popit에 처음 글 올립니다. 저는 주로 IDS 등 네트워크 보안장비 로그 분석하는 일을 해왔구요. 앞으로 로그 분석이나 보안 관련된 개인적인 경험을 풀어볼까 합니다. 첫번째 주제는 '보안 분야의 로그 분석에 대한 인식'입니다. 지적 많이 해주시구요. 편의상 경어는 생략합니다. 어느 기관 강의하러 갔다가 생긴 일 좀 높으신 듯한 분과
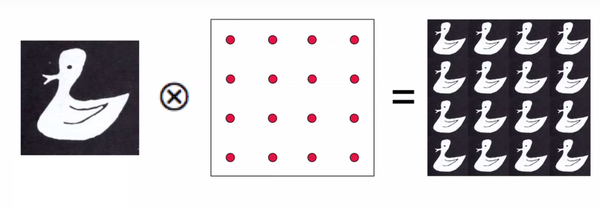
CNN과 영상처리에 대해서 공부하면서, Convolution에 대한 내용을 정리한 내용입니다. 제가 잘못 이해하고 있는 부분에 대해서는 언제든지 지적해주시면 감사하겠습니다. 1. Convolution & Correlation 1-1. Convolution, 합성곱 위키피디아에서 Convolution(영문)을 찾아보면 보면 정의는 다음과 같이 되어있습니다. - 1D Convolution - 2D Convolution 1-2. Correlation, 상관분석 수식 정의는 다음과 같습니다. - 1D Correlation
개요 알파고 등장 이후 시점으로 거의 대부분의 IT 기업에서 AI 그중에서도 머신러닝에 관심을 보이는 것을 어렵지않게 확인 할 수 있습니다. 그러나 이러한 트렌드에 맞추어 공부를 하기에는 막막하기도 하고 수학공식들에 압도당하기도 합니다. 2년 전쯤 인터넷에 유행했던 수학을 포기한 직업 프로그래머가 머신러닝 학습을 시작하기위한 학습법 글을 보면 Andrew. NG 교수의 코세라 머신러닝
안녕하세요. 오늘은 하둡3.0과 Erasure Coding에 대하여 얘기를 하고자 합니다. 저희 회사에서도 시스템 로그 및 유저 액티비티 로그들을 적재 할 공용 저장소 시스템을 구축 할 필요가 있게 되어서, 하둡을 사용하게 되었습니다. 아직 하둡 알파버전이지만, 3.0 버전에 대한 내용을 접한 곳은 홍태희님의 "업그레이드를 부르는 Hadoop 3.0 신규 기능
Spark 2.0 New Feature 중심으로 살펴보기 Spark2.0으로 업그레이드 되면서 이전 버전보다 좀 더 단순해지고 성능 개선을 위해 노력한 부분이 많이 있다. 이번 시리즈에서는 DataFrame API의 확장형인 type-safe한 Dataset에 대해 살펴 보려고 한다. 이미 Spark1.6에서 alpha버전이 소개된바 있다. Spark 데이터 구조 파악하기 * RDD * DataFrame(Spark 1.X
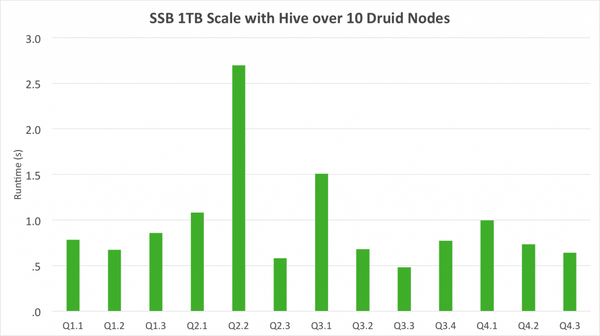
지난 Ultra-빠른 OLAP분석 시리즈 2편이 블로깅 되어 Ultra-빠르게 요약해 보았다. 이번 글에서는 Apache Hive와 연동된 Druid를 이용하여 초 단위 미만 분석을 수행한 결과를 리포팅하고 있다. 1TB의 OLAP데이터에 대한 벤치마크 결과는 다음과 같다. 평균 쿼리 응답 시간은 1초 미만이다. Star-schema Benchmark또는 SSB Benchmark는 기존의 데이터웨어 하우스의 응용 프로그램을
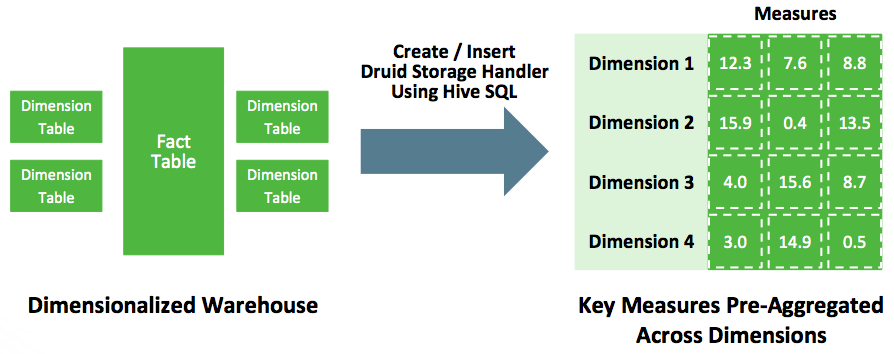
다음 글은 https://hortonworks.com/blog/apache-hive-druid-part-1-3/ 포스팅에 대한 요약글이다. 아직 part1 만 시작한 글이지만 얼마나 좋길래? 울트라란 용어를 남발하였는지 살펴 보기로 하자. 한줄 요약하자면 SQL-on-Hadoop기술의 de-facto Hive와 OLAP engine Druid가 만나 초고속 분석을 제공한다는 이야기이다. Druid는 고성능 컬럼 기반 분산 데이터
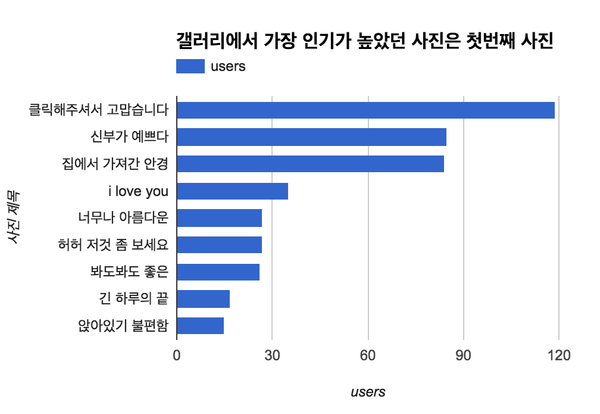
아래 글은 제 개인 블로그에 작성했던 글입니다. 작성한 지는 시간이 좀 지났지만 이런 류의 글도 팝잇에 업로드해도 되지 않을까 생각하면서 올립니다. - 어쩌다 보니 결혼한 지 2주차. 결혼 준비 중 그래도 가장 우리 마음 대로 할 수 있었던 모바일 청첩장에 대해서 말해보려고 한다. 원래는 청첩장도 직접 디자인하고 인장도 직접 찍으려고 했는데
개요 이번 포스팅에는 그룹핑 관련 함수와 도표 데이터를 다루기 시작하는것 까지 진행한다. 코드중심의 설명이기 때문에 본문 보다는 코드의 주석이 집중적으로 추가되어 있으니 참고 바란다. tapply 함수 사용하기 이미 배운 tapply 함수를 데이터프레임에서는 그룹핑에 활용 할 수 있다. > attach(mtcars) > tapply(mpg, am, mean) # mpg값을 am값으로 group화 하여 평균값(
최근 딥러닝 기반으로 이미지를 분류하는 앱을 시연해야하는 일이 생겼다. 주요한 요건은 기기-서버 사이의 네트워크 사용량을 최소화하는 것으로, 네트워크가 없는 곳에서도 사용이 가능해야 한다는 점이다. 따라서 모바일에서 촬영한 이미지를 서버로 전송하고, 서버에서 학습된 모델을 기반으로 이미지를 분류한 결과를 전달하는 API 방식은 사용할 수 없다. 대신 서버에서 학습한 모델을 모바일 기기에
개요 파이썬 쥬피터를 설치 및 실행하는 방법을 최대한 간단히 익혀 정리한다. 간단히 요약하자면 pip로 설치하고 파이썬 프로그램을 실행하면 로컬 서버로 쥬피터가 뜨는 원리이다. 이를 이용하면 아직 익숙하지 않은 텐서플로우 개발(특히 원격 서버를 통한 개발) 시 유용할듯 하여 포스팅 한다. 텐서플로우 코드를 라이브 코딩하거나 공유하기 위해서도 좋을듯 하다. 필자는 텐서플로우를
개요 이번 포스팅에는 R에서 사용하는 기초통계 관련 함수들을 알아본다. 해당강의에서는 기초통계학의 내용은 다루지 않고 기초통계학에서 사용하는 기법들을 R에서 어떻게 적용하는지 다룬다. 다만 참고를 위해 기초 통계학개념에 대해서는 위키피디아에서 발췌하여 추가해두었다. 코드중심의 설명이기 때문에 본문 보다는 코드의 주석이 집중적으로 추가되어 있으니 참고 바란다. 이번시간에 배울것들 요약 이번시간에는 아래와 같은 통계 지표들을