Latest

kubernetes 어디까지 써봤니? 삽질기(1)

Kubernetes 삽질의 시작 이 글은 kubernetes관련 삽질기로 시리즈로 연재될 예정이다. kubernetes에 대한 소개는 이전글을 참조하기 바란다. kubernetest(이하 k8s)는 오픈소스 컨테이너 관리 툴이다. k8s는 Go언어로 개발되어 있으며 경량의 이식 가능한 어플리케이션이다. k8s를 Linux기반의 OS에 올려 다수의 호스트에 클러스터 풀을 생성한후 docker컨테이너 어플리케이션을 올리고 관리하고 확장 가능하게 설정할 수 있다.
By jerryjung
RNN(Recurrent Neural Network)과 Torch로 발라드곡 작사하기

RNN(Recurrent Neural Network)과 Torch로 발라드곡 작사하기

최근 RNN(Recurrent Neural Network) 관련 자료를 찾다가 안드레이 카패시(Andrej Karpathy)가 쓴 The Unreasonable Effectiveness of Recurrent Neural Networks라는 글을 보게 되었다. 복잡한 수식 때문에 딥러닝 in Torch 책을 쓸 때도 잠깐 포기했었는데, 이 글에서는 RNN에 대해 개념적으로 쉽게 풀이했으며 무엇보다 학습 및 샘플링 코드를 모두 자신의 깃허브

By 송 준이
Kafka 운영자가 말하는 Kafka Consumer Group

Kafka 운영자가 말하는 Kafka Consumer Group

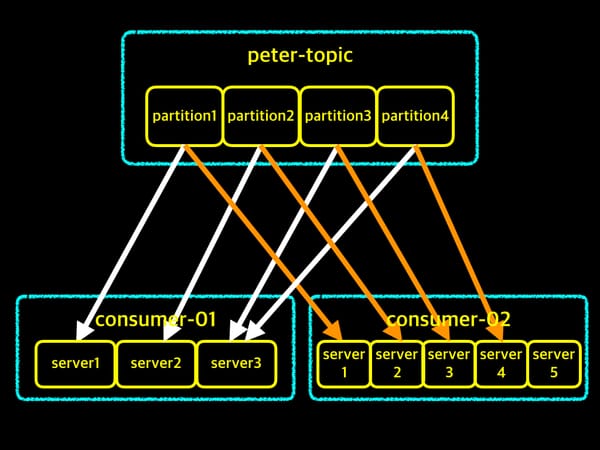
지난 글에 이어서 이번에는 Consumer Group이라는 주제를 가지고 설명하려고 합니다. 이 내용 역시 제가 처음 카프카를 접했을때, 정말 이해가 안되고 어려웠던 부분이었습니다. 컨슈머 그룹에 대해 국내 자료들을 검색했었는데, 안타깝게도 제가 이해하는데 도움이 될만한 글을 찾지 못하였습니다. 그래서, 제가 카프카를 처음 접하시는 분들이 컨슈머 그룹에 대한 개념을 잘 이해하실 수 있도록

By 고승범
[마케터를 위한 SQL #3] GROUP BY 살펴보기

[마케터를 위한 SQL #3] GROUP BY 살펴보기

SQL 의 많은 장점 중 GROUP BY 는 가장 유용하고 자주 사용하게 되는 구문 중 하나이며, 데이터의 양이 많아지고 컬럼이 늘어날수록 필수적으로 사용해야만 하는 구문입니다. GROUP BY 를 엑셀에서의 기능으로 본다면, 피벗(Pivot)과 유사한 역할을 한다고 보시면 되는데, 엑셀에서 피벗은 없어서는 안되는 필수 기능이기에 GROUP BY = PIVOT 으로서 초간단

By 홍 태희
[마케터를 위한 SQL #2] WHERE Clause 살펴보기

[마케터를 위한 SQL #2] WHERE Clause 살펴보기

이번 글에서는 데이터 조회 시, 필요한 데이터만 필터링 할 수 있도록 데이터의 조회 조건을 명시해주는 WHERE Clause 에 대해서 살펴보도록 하겠습니다. SQL 을 처음 접하시는 분이라면, 이전 포스팅을 참고해 주시기 바랍니다. /sql-for-marketers-1-select-clause/   데이터베이스 용어 및 개념 주요 Commands Database 에는 여러가지 유형은 명령어 종류들이 있습니다.

By 홍 태희
[마케터를 위한 SQL #1] 데이터 조회를 위한 SELECT Clause 살펴보기

[마케터를 위한 SQL #1] 데이터 조회를 위한 SELECT Clause 살펴보기

최근 사내에 데이터를 기반으로 일을 하시는 많은 분들에게 SQL 을 전파하고 있습니다. 글의 제목에는 마케터로 한정지어져 있지만, 평소 데이터를 가지고 엑셀 Pivot 이나 VLookup 등의 작업을 자주 하시는 분들이라면 SQL 을 익히시는 것이 매우 큰 도움이 됩니다. 특히 사내에 Data Warehouse 나 DB 시스템에 접근할 수 있는 분석환경이 제공된다면 더욱

By 홍 태희
[삽질기] JDBC를 통한 하둡 적재, 알면 도움되는 삽질 이야기 1편

[삽질기] JDBC를 통한 하둡 적재, 알면 도움되는 삽질 이야기 1편

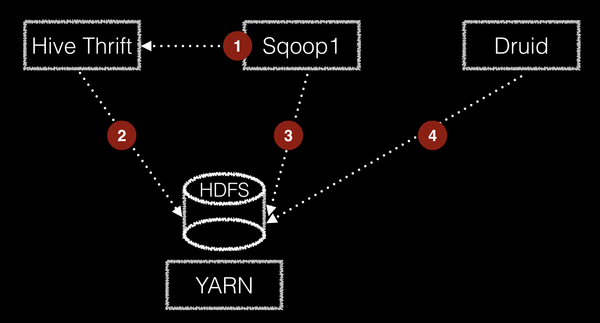
Pain past is pleasure! 이번 글에서는 JDBC를 통해 하둡에 데이터를 적재할때 한번 쯤 고민해 볼만한 주제로 삽질기를 공유하려고 한다. 먼저 필자가 경험한 내용은 아주 특이한 케이스로 일반적인 경우에 해당되지 않는다. 주위에 이런 삽질을 하는 사람도 있구나 라고 참고만 하시길... 기존 레거시에 있는 데이터 베이스로부터 하둡에 데이터를 적재할 때, 가장 많이

By jerryjung
#엑소사랑하자 - OpenFace로 우리 오빠들 얼굴 인식하기

#엑소사랑하자 - OpenFace로 우리 오빠들 얼굴 인식하기

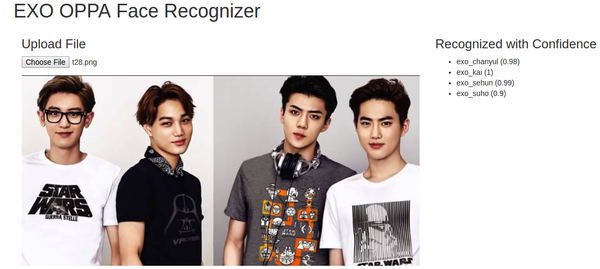
페이스북에 친구들의 사진을 등록하면, 친구 얼굴을 인식하여 이름을 자동으로 태그해준다. 페이스북 얼굴 인식 기술의 정확도는 97.35%정도라고 하는데, 이 정도 수준이면 안면 인식 장애가 있는 나 같은 사람보다도 뛰어나다. (그림 출처: Machine Learning is Fun! Part 4: Modern Face Recognition with Deep Learning) 이 글에서는 딥러닝 기반의 얼굴 인식

By 송 준이
빅데이터 시대, BI Solution (Spotfire) 활용법

빅데이터 시대, BI Solution (Spotfire) 활용법

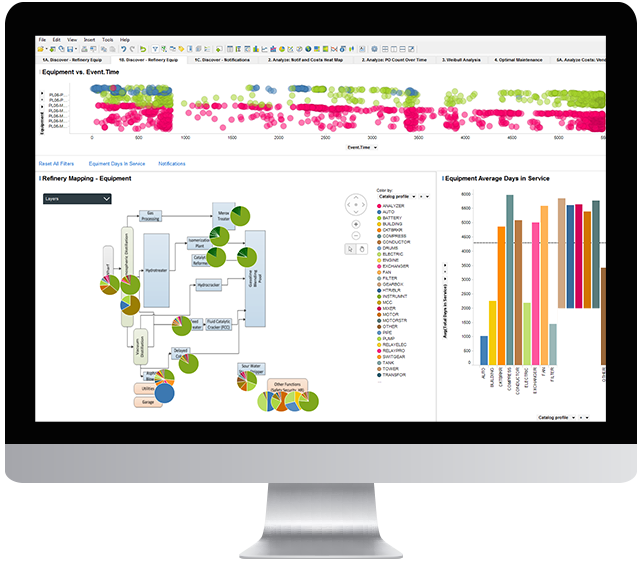
이번 글 에서는 대표적인 Business Intelligence(이하 BI) 솔루션 중 하나인 Spotfire 의 기능과 특성에 대해 살펴보고, 빅데이터 시대를 살아가며 효율적으로 BI 솔루션을 활용할 수 있는 분야와 방법에 대해 살펴보고자 합니다. 단, 솔루션 Provider 입장에서의 제품 홍보성 기능 설명이 아닌, 사용자 입장에서 경험했던 장점과 단점을 바탕으로 BI 솔루션의 적절한 적용

By 홍 태희
Recycled R - 패키지를 만들자

Recycled R - 패키지를 만들자

오늘 소개드릴 내용은 직접 R에서 사용하는 패키지를 만드는 방법입니다.  자신만의 패키지를 작성하는 것은 Code Recycle은 물론 Sharing과 Documentation에 큰 도움이 됩니다. 물론 save.image()로 현재 작업내용을 저장 할 수도 있고, source()나 CMD BATCH 커맨드라인 명령을 이용하여 미리 작성한 스크립트를 불러들여서 실행할 수도 있습니다.  그렇지만 패키지를 작성하게 되면 보다

By 벙어리장갑
우버 (Uber), 도대체 무엇이 특별할까? - 우버 분석

우버 (Uber), 도대체 무엇이 특별할까? - 우버 분석

우버 (Uber) 의 데이터를 활용한 특장점 공유경제의 대표적인 기업 '우버 (Uber)', 그리고 데이터 분석에 대해 간략하게 알아보도록 하겠습니다. 공유경제 (Sharing Economy)는 기존의 소비 패턴을 완전히 바꾸고 있으며 기존 물건을 구매하여 소유하는 '소유 경제'에서 불필요한 소비자원의 낭비를 줄이고 사회 공동의 이익이 기여한다는 점에서 매우 긍정적인

By rianchoi
Time series OLAP – Glue Architecture(5)

Time series OLAP – Glue Architecture(5)

Druid - 어벤저스 계획을 세우지 못하는 것은 실패를 계획하는 것이다 - 에피존스 람다 아키텍처는 데이터 처리 아키텍처로 대용량 데이터에 대한  배치 처리와 스트림 처리 방법을 활용하여 처리하기 위해 설계된  데이터 프로세싱 아키텍처이다. 아래의 아키텍처에서 수집된 레코드는 목적에 따라 배치와 실시간 처리 시스템으로 병렬적으로 제공되고 적재된 데이터는 필요 시 데이터를 질의 할 수

By jerryjung