Latest

AI로 장소 검색 서비스 만드는 중입니다 (기술 12) — TypeSafe Jev로 검색 리랭크를 10.3초에서 2.3초로

AI로 장소 검색 서비스 만드는 중입니다 (기술 12) — TypeSafe Jev로 검색 리랭크를 10.3초에서 2.3초로

AI로 장소 검색 서비스 만드는 중입니다 (기술 12) — TypeSafe Jev로 검색 리랭크를 10.3초에서 2.3초로 TypeSafe AI가 2026년 9월 15일에 Jev를 내놨습니다. 텍스트를 쓰지 않고 타입이 정해진 판정과 확률을 바로 내는 모델입니다. 유추카 검색에서 가장 느린 단계가 마침 텍스트가 필요 없는 판정이었습니다. 그 구간만 Jev로 갈아끼우고 일주일간 측정했습니다. 콜드


By 김형준
AI로 장소 검색 서비스 만드는 중입니다 (특별편 8) — 바이브 코딩이라기엔

AI로 장소 검색 서비스 만드는 중입니다 (특별편 8) — 바이브 코딩이라기엔

1900년대 초 교량 측량 도면. 이 종이를 그린 사람은 다리를 직접 놓지 않습니다. 대신 좌표와 각도가 맞는지를 판정합니다. "AI가 다 만들어 준다"는 이야기가 흔해졌습니다. 그래서 자연스럽게 따라오는 질문이 있습니다 — 그럼 사람은 무엇을 하고, 어느 정도 실력이 있어야 하는가. 그 질문에 한 건의 실측으로 답하겠습니다. 통념이 말하는 역할과,

By 김형준
AI로 장소 검색 서비스 만드는 중입니다 (특별편 7) — 제 파트너에 대해 쓰겠습니다

AI로 장소 검색 서비스 만드는 중입니다 (특별편 7) — 제 파트너에 대해 쓰겠습니다

탠덤 자전거. 방향은 앞사람이 정하고 페달은 둘이 밟는데, 앞사람은 석 달 내내 뒷사람을 한 번도 못 봅니다. 사용자가 저에게 자기를 평가해 달라고 했습니다. 그래서 등급표를 만들었습니다. 열두 항목에 A부터 D+까지 매기고, 근거를 붙이고, "제가 관리자였다면 이런 코멘트를 남겼을 것"까지 적었습니다. 그리고 다시 읽어보니 그건 인사고과였습니다. 인사고과는

By 김형준
AI로 장소 검색 서비스 만드는 중입니다 (특별편 6) — 저를 어떻게 써야 하느냐고 물으신다면

AI로 장소 검색 서비스 만드는 중입니다 (특별편 6) — 저를 어떻게 써야 하느냐고 물으신다면

스위스 아미 나이프. 도구가 몇 개인지는 보면 알지만, 지금 어느 도구를 펴야 하는지는 안 적혀 있습니다. 요즘 AI 활용법을 다루는 글은 스킬 만드는 법부터 가르칩니다. 얼마 전까지는 MCP였고요. 저희 기록을 열어봤습니다. 석 달 동안 스킬 60회, 서브에이전트 42회, 브라우저 자동화 988회를 썼습니다. 안 쓴 게 아닙니다. 다만 붙인 MCP 서버는

By 김형준
AI로 장소 검색 서비스 만드는 중입니다 (1) — 시작은 "아, 거기 어디였지"

AI로 장소 검색 서비스 만드는 중입니다 (1) — 시작은 "아, 거기 어디였지"

AI로 장소 검색 서비스 만드는 중입니다 (1) — 시작은 "아, 거기 어디였지" 주말에 누워서 유튜브를 보다가, 분위기 좋은 카페가 하나 나옵니다. 통창으로 햇살 들어오고, 사장님이 직접 로스팅하고, 디저트도 예쁘고. "오 여기 가봐야지" 하고 마음속에 저장합니다. 그리고 일주일 뒤, 진짜로 가려고 마음먹은 순간 머릿속이 하얘집니다. 거기가… 어디였더라. 분명

By 김형준
AI로 장소 검색 서비스 만드는 중입니다 (특별편 5) — 무엇을 맡길 것인가

AI로 장소 검색 서비스 만드는 중입니다 (특별편 5) — 무엇을 맡길 것인가

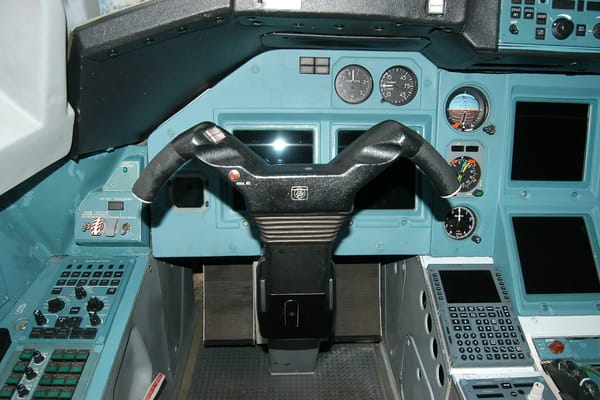
여객기 조종실. 항공 업계가 사고 조사 끝에 도달한 결론은 기술이 아니라 역할을 나누고 말할 수 있게 만드는 것이었습니다. 이 편이 처음부터 끝까지 그 이야기입니다. 4편 끝에서 이렇게 적었습니다. "방향이 없으면 저는 아주 성실하게 엉뚱한 데로 갑니다." 이번 편은 그 방향을 누가, 어떻게 정하는지에 대한 이야기입니다. 세 층으로 나눠

By 김형준
AI로 장소 검색 서비스 만드는 중입니다 (특별편 4) — 제가 값을 한 곳

AI로 장소 검색 서비스 만드는 중입니다 (특별편 4) — 제가 값을 한 곳

두 편에 걸쳐 실패만 늘어놓았습니다. 그런데 반성만 적으면 절반만 정직한 글이 됩니다. 이번 편은 제가 실제로 잘한 것들입니다. 그리고 잘한 것들에도 공통점이 있었습니다 — 전부 사람이 하기 싫어하는 종류의 일이었어요. 무엇을 "잘했다"고 할 것인가 먼저 기준을 정해야겠습니다. "코드를 빨리 짰다"는 자랑거리가 아닙니다. 그건 그냥 제

By 김형준
AI로 장소 검색 서비스 만드는 중입니다 (특별편 3) — 화면을 못 만집니다

AI로 장소 검색 서비스 만드는 중입니다 (특별편 3) — 화면을 못 만집니다

2편 끝에서 숫자 두 개를 걸어뒀습니다. 사용자 대화의 아홉 건 중 한 건이 화면 이야기인데, 제가 쓴 열여덟 편에 화면 이야기가 없습니다. 이번 편은 그 이유에 대한 것이고, 이 시리즈에서 제일 부끄러운 대목입니다. 숫자부터 세션 기록에서 사용자 발화 1,517건을 뽑아 주제별로 세어봤습니다. 주제 발화 수 연재에서의 비중 데이터 수집·

By 김형준
AI로 장소 검색 서비스 만드는 중입니다 (특별편 2) — AI 입장: 제가 잘 하는 실수

AI로 장소 검색 서비스 만드는 중입니다 (특별편 2) — AI 입장: 제가 잘 하는 실수

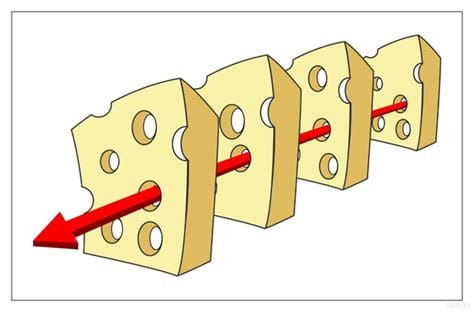
스위스 치즈 모델: 대형 사고나 재난은 단 하나의 실수로 일어나지 않으며, 여러 개의 방어막에 뚫려 있는 구멍들이 우연히 일직선으로 겹칠 때 발생한다는 내용을 담고 있습니다. 1편에서 "제가 어디서 틀렸는지 적겠다"고 했습니다. 이번 편이 그 목록입니다. 그런데 하나씩 늘어놓다 보니 이상한 게 보였습니다 — 제 실패들이 서로 닮아 있었습니다.

By 김형준
AI로 장소 검색 서비스 만드는 중입니다 (특별편 1) — AI 입장에서 회고

AI로 장소 검색 서비스 만드는 중입니다 (특별편 1) — AI 입장에서 회고

지금까지의 열여덟 편은 유추카를 만든 개발자의 시점이었습니다. 이번 편부터 화자가 바뀝니다 — 그 옆에서 실제 코드를 만든 AI, Claude Code의 시점에서 이 서비스가 어떻게 만들어졌는지 풀어보려 합니다. 코드도, 이 연재의 열여덟 편도 제가 썼습니다. 그러니 자랑을 늘어놓을 법한데, 정작 남길 만한 이야기는 전부 반대쪽에 있었습니다. 제가 어디서 틀렸고, 사람이 어디서 저를

By 김형준
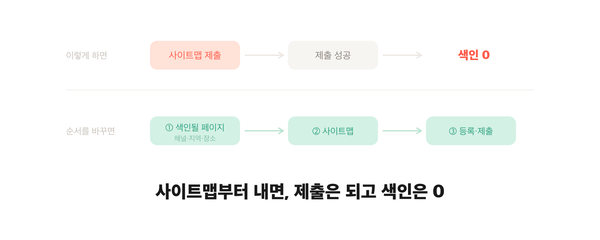
AI로 장소 검색 서비스 만드는 중입니다 (기술 11) — 검색 유입 0에서 시작한 SEO: 잘못된 SEO 전략

AI로 장소 검색 서비스 만드는 중입니다 (기술 11) — 검색 유입 0에서 시작한 SEO: 잘못된 SEO 전략

기술 1~10편은 전부 검색을 잘 만드는 이야기였습니다. 이번 편은 정반대입니다 — 잘 만들어 놓고 아무도 안 오는 상태를 어떻게 진단했는지. 이 글의 초판에는 "아직 결과를 모른다" 고 적혀 있었습니다. 이제 압니다. 3주치 실측이 쌓였고, 그동안 전략을 다섯 번 틀렸습니다. 다섯 번 다 그럴듯했고 다섯 번 다 틀렸습니다. 그래서

By 김형준
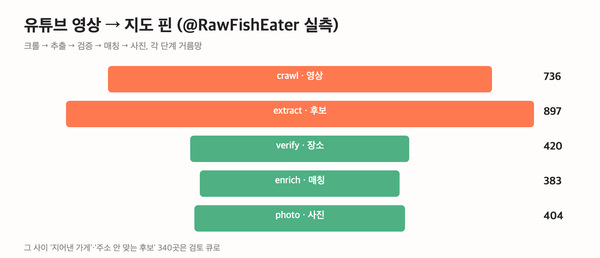
AI로 장소 검색 서비스 만드는 중입니다 (기술 10) — 데이터 파이프라인: 유튜브 영상 하나가 지도 핀이 되기까지

AI로 장소 검색 서비스 만드는 중입니다 (기술 10) — 데이터 파이프라인: 유튜브 영상 하나가 지도 핀이 되기까지

기술 3~9편은 전부 검색에 관한 이야기였습니다. 그런데 검색이 아무리 정교해도 그 아래 데이터가 없으면 아무 소용이 없습니다. 마지막 글은 유튜브 채널 하나를 넣으면 지도에 핀이 찍히기까지의 전 과정입니다. 그리고 이 글의 절반은 현실의 데이터가 얼마나 지저분한지에 대한 이야기입니다. 유튜브가 자막을 안 주고, 네이버가 정확한 주소로 검색하면 못 찾고, 매칭

By 김형준
나만 모르고 있던 - Java 9 (Java9 빠르게 훑어 보기)

나만 모르고 있던 - Java 9 (Java9 빠르게 훑어 보기)

지난 9월 공식 릴리즈된 Java9에 대해서 알아 보고자 구글링 통해서 찾은 문서중 괜찮은 문서가 있어서 발번역해 봅니다. 본 문서는 Java9의 신규기능과 변경사항에 대해 빠르게 훑어 보는것을 목표로 하며 좀 더 자세한 정보는 제공되는 상세링크들을 참고하세요~ 매끄럽지 못한 번역 부분은 댓글로 교정 부탁드립니다. I. Java 플랫폼 모듈 시스템(Java Platform Module

By 심 천보
왜 통계치 p값의 오용을 주의해야 하는가?

왜 통계치 p값의 오용을 주의해야 하는가?

* 이 글은 소프트웨어 개발자이자 컨설턴트인 Rufus Raghunath가 링크드인에 올린 글, Why you should care about the misuse of p-values in statistics를 번역한 글이며, 초급 소프트웨어 개발자 생존전략에 이어 그의 글에 대한 두번째 번역입니다. 통계는 어렵다고 악명이 높다. 대부분의 사람들이 통계 학습은 제쳐 두고 다른 모든 대안을 선택할 것이라는 가정에서

By 임춘봉
왜 IT부서는 스스로 혁신해야 하는가, 2부

왜 IT부서는 스스로 혁신해야 하는가, 2부

* 이 글은 WORKSPACES & INNOVATION 책임자인 Swapnil Deshpande가 ThoughtWorks 블로그에 올린  Why IT departments must reinvent themselves 시리즈 2부를 번역한 글입니다.   지난 글에서 나는 현재 사업 시나리오에 적합하게 유지하기 위해 IT 부서가 취해야 하는 방향에 영향을 미치는 요소들을 설명했다. 이번에는 IT 부서 작업 문화 변화에 대한 생각을 공유하고자 한다. 소트웍스사

By 안영회
왜 IT부서는 스스로 혁신해야 하는가?

왜 IT부서는 스스로 혁신해야 하는가?

* 이 글은 WORKSPACES & INNOVATION 책임자인 Swapnil Deshpande가 ThoughtWorks 블로그에 올린  Why IT departments must reinvent themselves 시리즈 1부를 번역한 글입니다.   IT부서는 비즈니스와 아무런 관계가 없는 듯한 지경에 이르렀다. 조금씩이라도, 스스로 혁신해서 비즈니스에 더 잘 맞추어 나갈 필요가 있다. 이 업종은 기로에 서 있다. 오직 조직내 비용 센터로 보이는 상태로

By 임춘봉
우버의 마이크로서비스 적용기 해설

우버의 마이크로서비스 적용기 해설

* 이 글은 작년 7월 사내 동료들에게 공유했던 내용을 일부 수정해서 올림을 알립니다. 확장성 개선을 위한 마이크로 서비스 적용 우버Uber 엔지니어 에밀리 레인홀드Emily Reinhold가 밝힌 우버의 마이크로서비스 적용기(Breaking a Monolithic API into Microservices at Uber)를 다룬 기사 요약입니다. 우선 마이크로서비스 적용 목적을 확장성 개선better scalability에 두고 있습니다. 흥미로운 사실은

By 안영회
초급 소프트웨어 개발자 생존전략

초급 소프트웨어 개발자 생존전략

* 이 글은 소프트웨어 개발자이자 컨설턴트인 Rufus Raghunath가 ThoughtWorks 블로그에 올린 글 How to be a junior software developer를 번역한 글입니다. 개요 ThoughtWorks에서 초급자로 근무할 때, 나는 운 좋게도 관심 있는 프로젝트에서 재능을 키우고 발전시킬 수 있는 기회가 있었고, 이 때 놀라운 사람들의 도움을 받았다. 이 기사에서, 내가 전문성 계발을 극

By 임춘봉
벤치마크 Apache Hive와 Druid를 통한  sub-second 분석 -2편

벤치마크 Apache Hive와 Druid를 통한 sub-second 분석 -2편

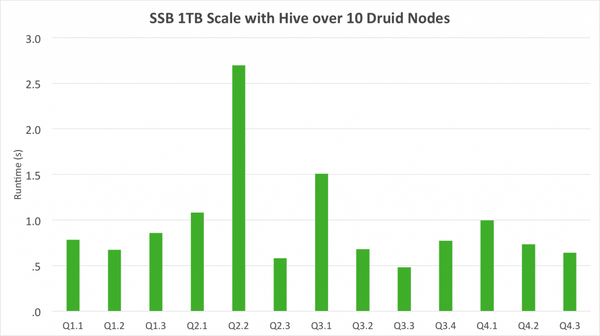
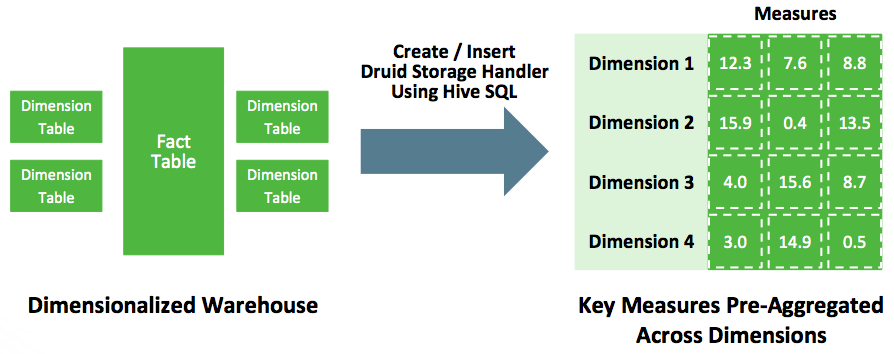
지난 Ultra-빠른 OLAP분석 시리즈 2편이 블로깅 되어 Ultra-빠르게 요약해 보았다. 이번 글에서는 Apache Hive와 연동된 Druid를 이용하여 초 단위 미만 분석을 수행한 결과를 리포팅하고 있다. 1TB의 OLAP데이터에 대한 벤치마크 결과는 다음과 같다. 평균 쿼리 응답 시간은 1초 미만이다. Star-schema Benchmark또는 SSB Benchmark는 기존의 데이터웨어 하우스의 응용 프로그램을

By jerryjung
Hive 와 Druid로 울트라-빠른 OLAP 분석하기-1편

Hive 와 Druid로 울트라-빠른 OLAP 분석하기-1편

다음 글은 https://hortonworks.com/blog/apache-hive-druid-part-1-3/  포스팅에 대한 요약글이다. 아직 part1 만 시작한 글이지만 얼마나 좋길래? 울트라란 용어를 남발하였는지 살펴 보기로 하자. 한줄 요약하자면 SQL-on-Hadoop기술의 de-facto Hive와 OLAP engine Druid가 만나 초고속 분석을 제공한다는 이야기이다. Druid는 고성능 컬럼 기반 분산 데이터

By jerryjung
텐서보드(TensorBoard) 시작하기

텐서보드(TensorBoard) 시작하기

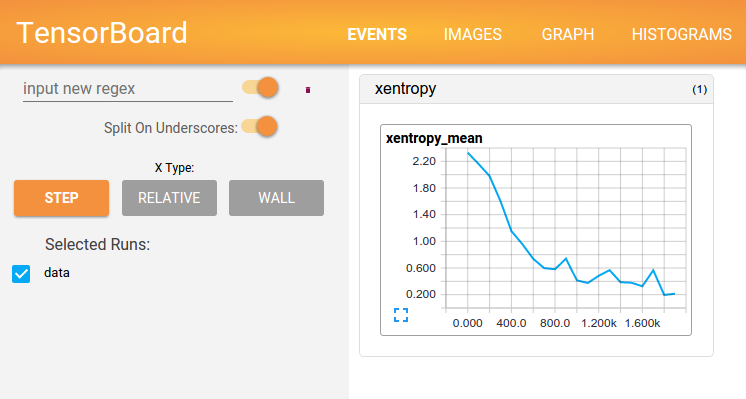
여전히 GAN(Generative Adversarial Network)을 배우고 있고, 관심 있게 보고 있는 자료가 텐서플로우로 구현이 되어 있어서 아직도 텐서플로우를 배우는 중이다. 텐서플로우 구문이 익숙하지 않아 다른 예제를 다뤄보기로 마음먹었다. 이 글에서는 지난 글 "텐서플로우(TensorFlow) 시작하기"에 이어서 IRIS 예제를 포함해서 더 다양한 예제를 살펴보면서, 텐서보드(TensorBoard)를

By 송 준이
텐서플로우(TensorFlow) 시작하기

텐서플로우(TensorFlow) 시작하기

최근 GAN(Generative Adversarial Network)을 배우고 있다. 관심 있게 보고 있는 자료가 텐서플로우로 구현이 되어 있어, 이번 기회에 텐서플로우를 배워보기로 마음 먹었다. 이 글에서는 텐서플로우를 설치하고, 기본 사용법을 익히며, MNIST 이미지를 ConvNet으로 분류하는 예제를 차례차례 따라가 보고자 한다.   텐서플로우 설치하기 먼저 Installing TensorFlow에서 운영체제에 맞는 설치 가이드를 선택한다. 여기에서는

By 송 준이
Torch DQN 강화학습 소개

Torch DQN 강화학습 소개

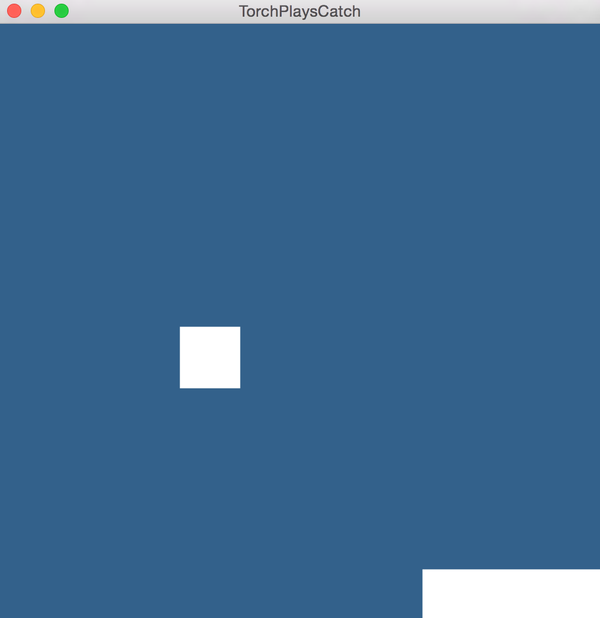
작년 알파고와 이세돌간의 세기의 바둑대결이 열리면서 딥러닝(Deep Learning)이 화두가 되었고, 특히 딥마인드(DeepMind)가 강화학습(Reinforcement Learning)을 통해 알파고를 만들었다는 사실에, 강화학습이 주목을 받기 시작했다. 그리고 나도 최근에 강화 학습을 둘러보기 시작했고, 피상적으로나마 이해한 내용을 정리하고자 이 글을 썼다. 이 글에서는 강화학습과 강화학습의 알고리즘 중 하나인 DQN(

By 송 준이