[입 개발] base64 가 있는데 base62 같은걸 왜 써야 하나요?
몇일 전에 [입 개발] base62와 진법 연산 라는 글을 적었습니다. 이런 내용을 얘기하면 꼭 빠지지 않고 좋은 질문이 하나 꼭 나옵니다.(나오기를 바랍니다.) "왜 base64가 있는데 base62 같은걸 써야하죠?" 넵 그렇습니다. 다행히도, 이 내용을 제 주변에 설명했을 때도, 들었던 질문이고, 해당 글을 적었을 때도 받은 질문입니다.(좋은 질문해주신
 Pop your eXperience. Share It.
몇일 전에 [입 개발] base62와 진법 연산 라는 글을 적었습니다. 이런 내용을 얘기하면 꼭 빠지지 않고 좋은 질문이 하나 꼭 나옵니다.(나오기를 바랍니다.) "왜 base64가 있는데 base62 같은걸 써야하죠?" 넵 그렇습니다. 다행히도, 이 내용을 제 주변에 설명했을 때도, 들었던 질문이고, 해당 글을 적었을 때도 받은 질문입니다.(좋은 질문해주신
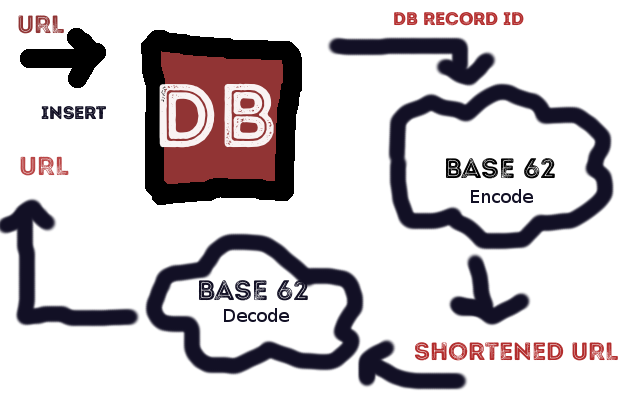
혹시 shorten url 서비스 같은 것을 어떻게 구현할 것인가에 대해서 고민해 본적이 있으신가요? 이런 서비스를 제공할려고 보면, 겹치지 않는 유니크한 값을 만들어야 합니다. 이건[입 개발] Global Unique Object ID 생성 방법에 대한 정리 를 참고하시면 됩니다. 그런데 이런 값을 그냥 스트링 형태로 표현하면, 123456789 은 binary 로는 4byte 이지만,
지난 10월 26일, 루씬 6.2.0을 기반으로 한 Elasticsearch 5.0.0 GA 버전이 공개되었다. 이 글에서는 Elasticsearch 5.0.0 릴리즈 노트에서 설명한 내용 중에서 내가 살펴 본 내용들을 간추렸다. 색인 성능 아래의 주요 변경 내용으로 인해 색인 성능이 25% ~ 80% 정도 향상된다. 블록 KD 트리 데이터 구조
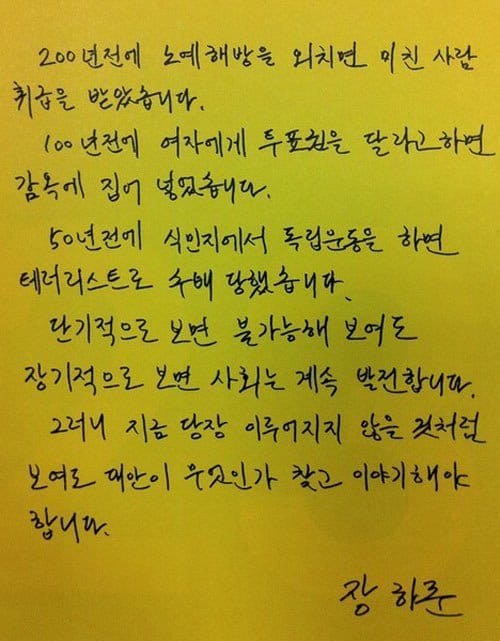
2010년 OKKY에 옛날 선배 개발자분들 정말 짜증납니다.라는 제목으로 글이 올라왔다. 선배 개발자로서 미안함과 안타까운 마음이 들어 장문의 글을 적었던 기억이 난다. 이 친구의 불만은 6년이 지난 지금도 개선되지 않고 있다. 특히 SI 환경은 2010년보다 더 열악한 환경이 되었다. 2010년에 썼던 이 글은 아직도 유효하다는 생각이 들어 다시 소환해 본다.
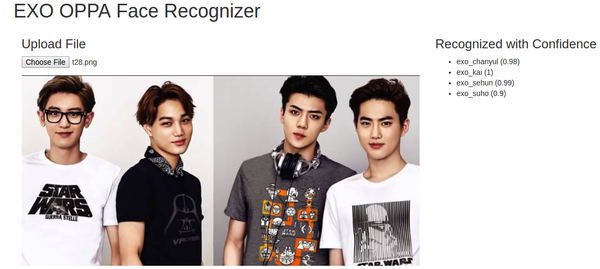
페이스북에 친구들의 사진을 등록하면, 친구 얼굴을 인식하여 이름을 자동으로 태그해준다. 페이스북 얼굴 인식 기술의 정확도는 97.35%정도라고 하는데, 이 정도 수준이면 안면 인식 장애가 있는 나 같은 사람보다도 뛰어나다. (그림 출처: Machine Learning is Fun! Part 4: Modern Face Recognition with Deep Learning) 이 글에서는 딥러닝 기반의 얼굴 인식
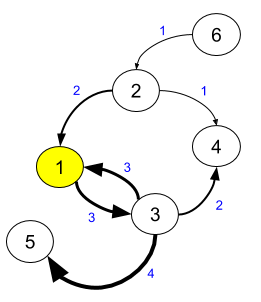
소개 요즘에는 REDIS를 사용하지 않는 곳을 찾아보기가 힘들 겁니다. 세션 데이터, 토큰, 유저 요청, 처리 결과, 메시지 박스 등 다양한 목적으로 사용을 합니다. 이번 포스트에서는 REDIS를 이용한 데이터 모델링에 대한 내용을 다루고 있습니다. 가능하면 개발 현장에서 있음직한 요구들을 중심으로 내용들을 채워볼 생각입니다. 이 문서는 REDIS 설치와 기본적인 사용법등에 대해서는 다루지
먼저 이 글은 10개월동안 업데이트가 되지 않아 죽어가던 블로그를 살리기 위한 잡담 섞인 글임을 밝힙니다. 2012년 신입시절부터 개인 블로그 를 통해 저와 같은 Junior 개발자를 대상으로 소프트웨어 개발을 하면서 겪은 경험을 공유하거나 스스로 리마인드 하기 위한 내용을 정리하기 시작하였는데, 이 블로그를 통해서 데이터의 규모는 작지만 개발자들이 어떻게 기술 문서를 검색하는가에
최근 bootstrap 사용할 일이 있어 초기 설정 중에 다음과 같은 에러 사항이 발생하여 몇가지 확인을 해 봤습니다. 자바스크립트 오랜만에 하려니 이런것도 삽질하게 되네요. Bootstrap's JavaScript requires jQuery version 1.9.1 or higher, but lower than version 3 bootstrap에서는 jquery 1.9.1 이상이 필요한데 version 3 보다
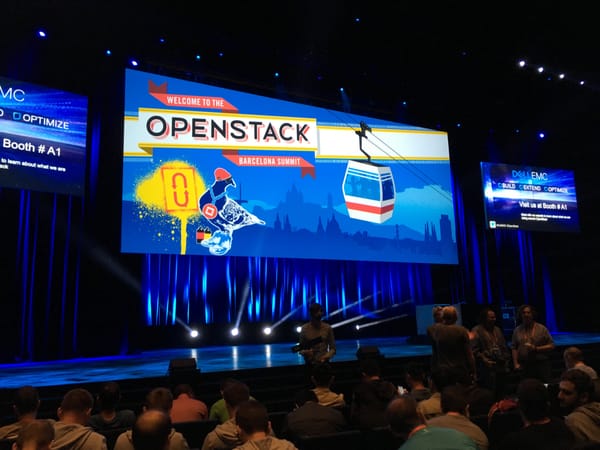
오픈스택 디자인 서밋(Design Summit) 은 1년에 상반기(4월 혹은 5월), 하반기(10월 혹은 11월) 두번 열리며 보통 4~5일 동안 진행됩니다. 초장기 디자인 서밋은 개발자들이 룸에 모여 개발할 내용을 논의하고 결정하는 10여명 내외의 조촐한 모임이었으나 지금의 디자인 서밋은 대규모 컨퍼런스로 발전했습니다. 키노트를 통해 오픈스택을 활용하는 Use Case 나 인상깊은
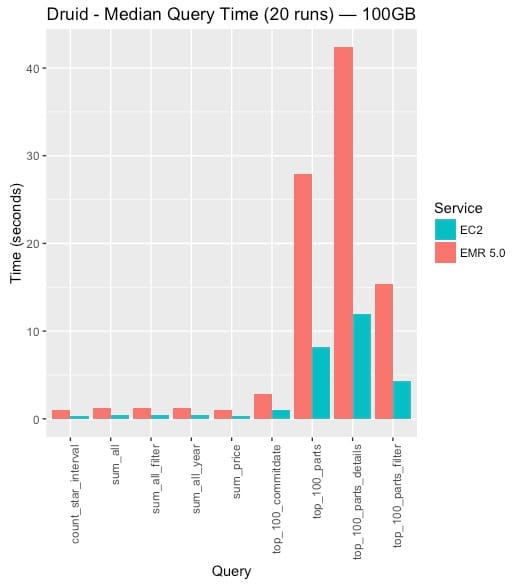
들어가면서.. Druid는 Timeseries 데이터를 자체에 내장된 Lambda architecture 구조를 기반으로 데이터의 eventually exactly-once delivery를 보장하는 시스템입니다. 또한 데이터 적재시에 지정한 단위 시간 기준의 rollup(pre-aggregation)을 통한 데이터 축약과 column기반의 dictionary 인코딩 및 bitmap 자료구조로 복수개의 임의의 조합으로 구성된 column들에 대한 aggregation 질의에 대하여 sub-second수준으로 응답할 수

지금까지 두 번의 글을 통하여 조직이 커지면서 생산성이 떨어지는 이유에 대하여 살펴보았다. 첫 번째 글에서는 생산성이 떨어지는 가장 큰 원인이 업무와 조직의 세분화라고 이야기했다. 두 번째 글에서는 이 같은 세분화가 어떠한 문제점을 가지고 있는지는 지난 글에서 다루었다. 그렇다면 소프트웨어 개발 회사는 어떤 형태의 조직 구조와 업무 형태를 가져야할까? 지금부터 내가
최근 Hadoop 관련 메이저 두 회사에서 SQL on Hadoop 관련해서 벤치마킹 자료를 잇따라 공개하였습니다. * Cloudera: Apache Impala (incubating) vs. Amazon Redshift * Hortonworks: APACHE HIVE VS APACHE IMPALA QUERY PERFORMANCE COMPARISON 이 벤치마킹 자료에 대해 필자도 뭔가 이야기를 하고 싶었지만 검증해 볼 환경이 없어 다른 곳에서 리뷰가 올라오기를 기다렸는데 마침 ZDNet에서