Vim 사용자 정의 파일 타입 꾸미기
Linux Programmer 자리에서 쉽게 찾아 볼 수 있는 Vim Cheat Sheet 입니다!! 이 글은 Emacs 파는 skip 하셔도 됩니다. ^^; 0. Syntax Hightlight 이 글은 "우리만의 log format", "SQL 같은 Syntax 를 지원하는", "Unknown File Format" 등을 highlight 없이 무미건조하게 보다는 경우를 위해서 Vim Syntax
 Pop your eXperience. Share It.
Linux Programmer 자리에서 쉽게 찾아 볼 수 있는 Vim Cheat Sheet 입니다!! 이 글은 Emacs 파는 skip 하셔도 됩니다. ^^; 0. Syntax Hightlight 이 글은 "우리만의 log format", "SQL 같은 Syntax 를 지원하는", "Unknown File Format" 등을 highlight 없이 무미건조하게 보다는 경우를 위해서 Vim Syntax
들어가며 최근 챗봇(chatbot)에 대한 관심이 증가하고 있다. 페이스북, 구글, MS 등 글로벌 공룡기업들은 이미 오래전부터 인공지능 기반의 챗봇을 연구했다. 또한 자연어처리와 인공지능 관련 스타트업을 인수함과 동시에 그 성과물을 공개하면서 공격적인 행보를 보이고 있다. 예를 들어 페이스북이 인수한 wit.ai, 구글이 인수한 api.ai 등은 챗봇을 개발할 수 있는
리눅스를 개발한 리누스 토발스가 만든 소스 코드 형상관리 도구인 git이 인기를 끌면서 많은 오픈소스 프로젝트가 git을 이용하고 있습니다. git 의 인기에는 git 이 제공하는 개념과 컨셉이 기존 형상관리 도구보다 뛰어나기도 하지만 git 레포지토리를 클라우드로 서비스하고 있는 github.com의 존재도 큰 영향을 했습니다. 최근에는 오픈소스 프로젝트 뿐만 아니라 많은 기업들이 github.
오픈스택은 프로젝트 마다 자신의 고유 기능을 갖고 있으며 서로 유기적으로 연결된다고 할 수 있습니다. 예를 들어 Nova 는 VM (Virtual Machine) 생성/삭제/조회와 관련된 기능을 갖고 있으며, Glance 는 OS 이미지 생성/삭제/조회 기능을 갖고 있습니다. VM 을 생성하기 위해서는 OS 이미지 파일이 필요한데 Glance 와 통신하여 이미지를
CQRS (Command and Query Responsibility Segregation) 란? CQRS는 네이밍에서 알 수 있듯이 명령과 쿼리의 역할을 구분 한다는 것이다. 즉 커맨드 ( Create - Insert, Update, Delete : 데이터를 변경) 와 쿼리 ( Select - Read : 데이터를 조회)의 책임을 분리한다는 것이다. CQRS는 새롭게 등장한 개념은 아니고 등장한지 조금된 패턴 이다. (버트란드 마이어(Bertrand Meyer) 의
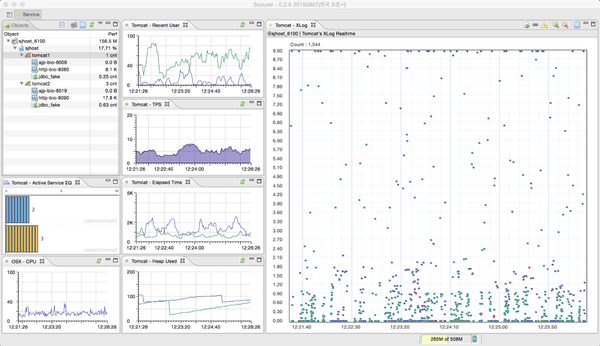
Scouter 에 대한 소개 글들이 조금 존재하기는 하지만, 여기서는 조금 더 자세한 소개를 하고자 한다. Scouter는 LG CNS 에서 만들어 공개한 오픈소스(https://github.com/scouter-project/scouter) APM(Application Performance Monitoring) 이다. 참고) APM 은 애플리케이션의 성능을 모니터링 / 통제하는 도구로 2016년 현재 아주 많은 종류의 APM 이 존재한다. 대표적인
오늘 소개드릴 내용은 직접 R에서 사용하는 패키지를 만드는 방법입니다. 자신만의 패키지를 작성하는 것은 Code Recycle은 물론 Sharing과 Documentation에 큰 도움이 됩니다. 물론 save.image()로 현재 작업내용을 저장 할 수도 있고, source()나 CMD BATCH 커맨드라인 명령을 이용하여 미리 작성한 스크립트를 불러들여서 실행할 수도 있습니다. 그렇지만 패키지를 작성하게 되면 보다
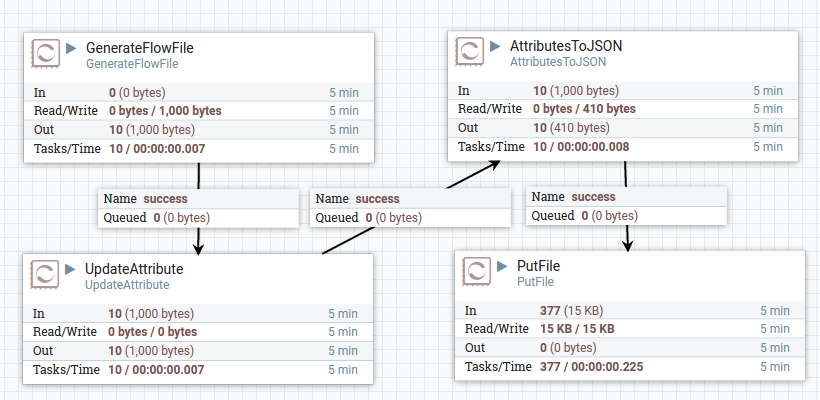
Apache NiFi는 NSA(National Security Agency)에서 Apache에 기증한 Dataflow 엔진입니다. 복잡해지는 기업의 시스템들에서 신속하고, 유실 없는 데이터 전송은 점점 더 중요해 지고 있습니다. 빅데이터 시스템도 마찬가지로 데이터의 전송 경로가 더 복잡해지고, 실시간 처리가 중요해지는 시점에 Apache NiFi는 훌륭한 솔루션입니다. 여기서는 NiFi의 소개와 설치에 대해서 알아보도록 하겠습니다. 본 글은 저자가
우버 (Uber) 의 데이터를 활용한 특장점 공유경제의 대표적인 기업 '우버 (Uber)', 그리고 데이터 분석에 대해 간략하게 알아보도록 하겠습니다. 공유경제 (Sharing Economy)는 기존의 소비 패턴을 완전히 바꾸고 있으며 기존 물건을 구매하여 소유하는 '소유 경제'에서 불필요한 소비자원의 낭비를 줄이고 사회 공동의 이익이 기여한다는 점에서 매우 긍정적인
이글은 Why Microservices?(https://dzone.com/articles/microservices-basics?edition=213185)의 번역글 입니다. 해당 기사는 마이크로서비스 아키텍처를 적용할 때의 장점과 단점 모두를 많은 사람들이 익숙한 모놀리스(monolithic) 방식의 소프트웨어와 비교해 개략적으로 설명하고 있습니다. 혹시라도 번역에 대한 오류, 오타등을 발견하시면 댓글에 남겨주시길 부탁드립니다. 이 번역글을 읽고 나서 마이크로서비스에 대해 좀
제가 Rails에 대한 블로그 글을 쓰는 날이 드디어 왔군요. 일단 간단한 Tip 입니다. Rails로 첨부파일을 저장할 경우 CarrierWave를 많이 사용합니다. CarrierWave를 사용하게 되면 로컬 저장소 뿐만 아니라 S3 저장소와도 쉽게 연동이 되며 이미지 파일의 경우 thumbnail 이나 해상도별로 여러 버전을 쉽게 만들 수 있습니다. 다음 예제와 같이 특정 모델에 저장된
Hadoop은 크게 두가지 컴포넌트로 구성되는데 하나는 파일을 저장할 수 있는 분산 파일 시스템인 HDFS(Hadoop Distributed File System)과 분산 컴퓨팅 환경을 제공하는 YARN(Yet Another Resource Negotiator) 입니다. Hadoop 을 처음 접하시는 분들은 HDFS에 대해서는 쉽게 이해하지만 YARN에 대해서는 개념을 잡기 어려워하시는 분들이 있습니다. 그 이유는 Hadoop하면 MapReduce를 많이