Latest

Hive Query 의 Hadoop Job Id (YARN) 알아내기

Hive Query 의 Hadoop Job Id (YARN) 알아내기

필요성 Hive Client 프로그래밍을 하다보면 Client 에서 실행한 Hive Query의  Job Id 값을 알아내야 하는 경우가  있습니다. 저의 경우에는 이전 글을 통해 공개되었던 Hadoop Data Warehouse 의 데이터 분석환경으로 Hive Query Language 를 수행할 수 있는 Zeppelin 과 매우 유사한 분석 툴을 직접 개발하여 사용하고 있는데, 이 툴에서 실행된 Job
By 홍 태희
오픈소스: 코드 분석 어떻게 하나?

오픈소스: 코드 분석 어떻게 하나?

MySQL, Apache, Tomcat 등과 같은 오픈 소스는 매뉴얼이나 문서, 책 등도 많이 나와 있으며 오픈 소스이지만 솔루션 자체도 안정적이라서 특별한 이유가 아니면 소스를 분석할 필요는 없습니다. 하지만 Hadoop이나  HBase  등과 같은 솔루션은 문서도 부족하지만 문서로만 설명할 수 없는 복잡한 내용으로 구성되어 있는 솔루션이 많습니다. 따라서 제대로 솔루션을 사용하거나 운영하기 위해서는

By 김형준
NiFi를 이용한 빅데이터 플랫폼 개선

NiFi를 이용한 빅데이터 플랫폼 개선

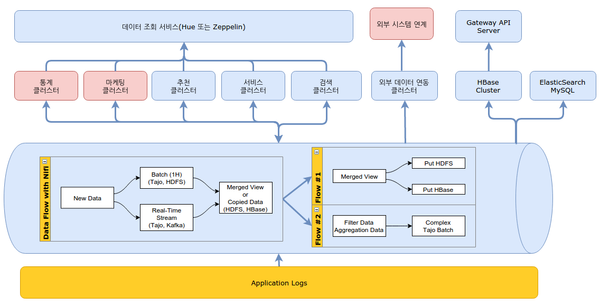
복잡해지는 빅데이터 클러스터 간에 데이터 동기화와 투명한 데이터 관리를 위한 고민을 공유하고, 이 문제를 해결하기 위한 오픈소스인 Apache NiFi를 소개하겠습니다. 연관 글: 멜론-빅데이터-이야기 소개 어떤 시스템이나 그렇듯 빅데이터 시스템도 여느 시스템과 같이 비즈니스 요건에 따라 점점 진화하게 되는데, 2011년 빅데이터로 불리는 하둡과 에코 시스템 모습과 현재의 빅데이터 시스템은

By 병화 윤
PayPal 은 어떻게 하루에 10억 request 를 단 8개 VM 으로 처리하는가?

PayPal 은 어떻게 하루에 10억 request 를 단 8개 VM 으로 처리하는가?

이 글은 highscability.com 에서 소개된 글에 대한 번역입니다. 원문을 최대한 전달하기 위해서 노력했습니다. ^^;; 원문은 다음에서 확인하실 수 있습니다. * 원문 : http://highscalability.com/blog/2016/8/15/how-paypal-scaled-to-billions-of-transactions-daily-using-ju.html PayPal 의 성과 최근에 PayPal 은 자신들이 운영하던 VM(Virtual Machine) 의

By junkikim
구글이 만든 Docker Container Orchestration 툴, Kubernetes 소개

구글이 만든 Docker Container Orchestration 툴, Kubernetes 소개

Intro 이 글에서는 Kubernetes 가 무엇인지 설명하고, 아키텍쳐와 구성요소에 대해 살펴봅니다. 그리고 minikube 를 이용해 로컬에서 Kubernetes 를 사용해 보겠습니다. 목차는 아래와 같습니다. * What is Kubernetes? * Kubernetes Architecture (abbreviated) * Getting Started with minikube * Kubernetes Object: Pod * Kubernetes Object: Service * Kubernetes Object: Deployment * Kubernetes Object: Pet Set * Kubernetes Object: Others * Summary

By 1ambda
Presto Kafka connector 개선 실패기

Presto Kafka connector 개선 실패기

이 글은 Presto 관련해서 계속 연재되는 글 중 하나입니다. 이전글을 못보신 분들은 다음 글을 참고하세요. Presto SQL을 이용하여 Kafka topic 데이터 조회하기 Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(1) Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(2)   다 읽고 실망하실 분들을 위해 미리 밝히지만 이글은 실패한 삽질기

By 김형준
아파치 실시간 처리 프레임워크 비교분석 (2)

아파치 실시간 처리 프레임워크 비교분석 (2)

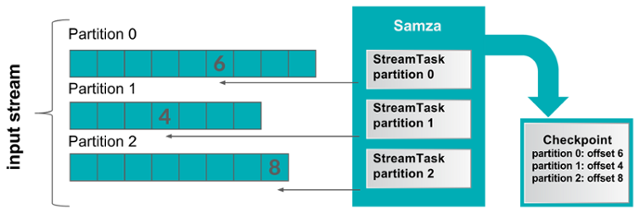
이전글 : 아파치-실시간-처리-프레임워크-비교분석 (1) 지난 글 에서는 아파치 프로젝트로 오픈되어 많은 인기를 얻고있는 Storm, Trident, Spark, Samza, Flink 에 대한 기본 특성과 분산 플랫폼의 필수 이론을 살펴보았습니다. 이번 글 에서는 무정지형(Fault Tolerance) 시스템구축, 상태관리, 성능 등의 좀더 깊이있는 주제와 더불어 실시간 스트리밍 처리 플랫폼에 대한 가이드라인

By 홍 태희

Presto SQL을 이용하여 Kafka topic 데이터 조회하기

Presto는 다양한 저장소를 지원하고 있는데 데이터 수집을 위해 Queue로 많이 사용되고 있는 Kafka도 기본적으로 제공하고 있습니다. 즉, Kafka의 topic에 저장된 데이터를 Presto SQL을 이용하여 조회할 수 있으며 Hadoop, S3, MySQL 등에 저장된 테이블과 Join 연산도 가능하다는 의미입니다. Presto와 Kafka를 연결하려는 이유는 저희 로그 데이터는 S3에 저장되는데 S3의 경우 Block Storage가

By 김형준
오픈스택(OpenStack) 이란?

오픈스택(OpenStack) 이란?

클라우드라는 단어를 사용한 개발자라면 오픈스택이라는 단어를 최소 한 번은 들어보셨을 겁니다. 오픈스택은 Rackspace와 NASA에서 시작한 IaaS(Infrastructure As A Service) 를 구축할 수 있는 Software로 글로벌 IT 업체의 대부분이 참여하고 있는 오픈소스 프로젝트로 IaaS라는 단어에서 알 수 있듯이 클라우드 인프라에 필요한 서버 가상화, 스토리지 가상화, 네트워크 가상화 기술들을 종합적으로 구현하였습니다.

By Seungkyu Ahn
InfluxDB, Telegraf, Grafana 를 활용한 Monitoring System 만들기(2)

InfluxDB, Telegraf, Grafana 를 활용한 Monitoring System 만들기(2)

데이터 저장소로 InfluxDB를 설치 했으면 다음으로는 모니터링 데이터를 수집해야 할 것입니다.데이터 수집에는 다양한 방법이 있지만 여기서는 Telegraf를 이용하는 방법을 설명합니다.Telegraf를 선택한 이유는 InfluxDB와 마찬가지로 Go언어로 개발되어 설치가 매우 간편하고 다양한 종류의 수집/저장 플러그인을 간단한 설정으로 사용 가능하기 때문입니다.실제 MariaDB 5.5, mysql 5.6 에서 약

By 유 승민
원맨 스타트업 - 시작하기

원맨 스타트업 - 시작하기

개발자라면 누구나 자신만의 서비스를 만들고 싶다는 꿈을 그릴 것입니다. 또는 새로운 기술이 발표되거나 서비스가 릴리즈될 때마다 한번 쯤은 "아, 이 아이디어는 나도 생각해 봤었는데.."라는 가벼운 아쉬움(?) 정도는 느껴본 경험이 있으리라고 봅니다. 하지만 대개 늘 그렇듯이, 상상에만 머물고 재빠르게 현실로 되돌아가버린채 밀린 업무를 쳐나갑니다. 저 또한 마찬가지입니다. 자영업자로

By 송 준이