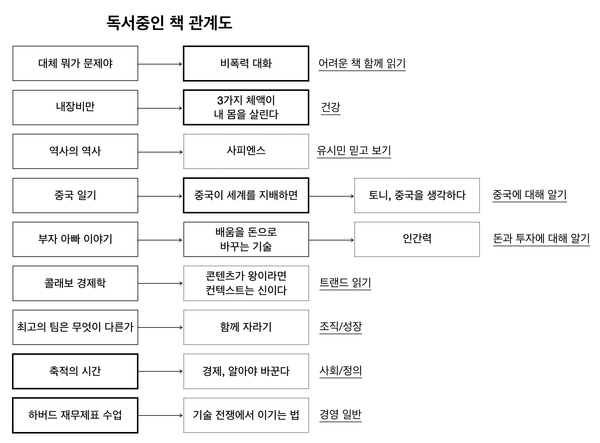
읽고 있는 책을 돌아보고 관심 분야에 집중하게 하기
제목에 신경을 썼다. 이 글을 왜 쓰는지 생각해 보고 싶었고, 읽는 이에게 도대체 가치가 있을 수 있나 싶은 회의적인 마음이 들어 집중해서 선언해봤다. 여러 권을 함께 읽는 병렬 독서 습관 군대 동기가 사물함에 책을 여러 권을 두기에 '그걸 다 읽냐'고 물었던 기억이 있다. 자신은 동시에 여러 권을
 Pop your eXperience. Share It.
제목에 신경을 썼다. 이 글을 왜 쓰는지 생각해 보고 싶었고, 읽는 이에게 도대체 가치가 있을 수 있나 싶은 회의적인 마음이 들어 집중해서 선언해봤다. 여러 권을 함께 읽는 병렬 독서 습관 군대 동기가 사물함에 책을 여러 권을 두기에 '그걸 다 읽냐'고 물었던 기억이 있다. 자신은 동시에 여러 권을
페이스북에 간단한 독후감을 쓰고도 아쉬워서 블로그 글로 남긴다. 먼저 이 책이 읽어볼만한 가치가 있느냐 묻는다면 '그렇다' 라고 답할 것이다. 묻는 대상이 주로 역사학자나 역사에 깊은 관심이 있는 사람이 아니라면 말이다. 한국판 역사란 무엇인가 누군가에게 한 줄로 소개하라면, 이책은 한국판 <역사란 무엇인가>라고 소개할 수 있다. 물론,
해당 코드는 Github에 공개되어있습니다. Spring Guide 1. Test 전략 가이드 2. Exception 전략 가이드 3. Domain 객체 가이드 4. 외부 API 가이드 5. Service 적절한 크기 가이드 스프링은 다양한 테스트 전략을 제공하고 있습니다. 대표적으로 Slice Test 라는 것으로 특정 레이어에 대해서 Bean을 최소한으로 등록시켜 테스트 하고자 하는 부분에 최대한 단위
[주의] * 이 글은 의식의 흐름대로 작성되었습니다. * 장문의 브레인 덤프를 읽기 어려운 임산부나 노약자는 창을 닫아주세요. * 내용 특성 상 팬심 드리븐 자발적 PPL이 포함되어 있습니다. 6년차 관록의 팟캐스트, 마케팅어벤져스가 한 권의 책으로 내가 처음 팟캐스트 '마케팅어벤져스'를 들었던 것은 모 글로벌 기업의 프로젝트에서 극도로 비효율적이고 기계적인 일을 맡았을 때였던가.
연휴[1]를 마치고 출근해서 처음으로 머리써서 처리한 일은 동료 개발자가 두레이에 남겨 놓고 간 작업입니다. 필자가 먼저 서울에 갔을 때 북경에 남아 있던[2] 그가 갱신한 작업 내용을 보고, 필자가 '무얼 더 개선할 수 있을까?' 생각하는 일입니다. 그가 나에게 작업을 요청한 것이 아니라 우리가 서로 나눴던 의견을
해당 코드는 Github를 확인해주세요. Repository Code public interface AccountRepository extends JpaRepository<Account, Long>, AccountCustomRepository { Account findByEmail(Email email); boolean existsByEmail(Email email); List<Account> findDistinctFirstBy... @Query("select *from....") List<Account> findXXX(); } JpaRepository를 이용해서 복잡한 쿼리는 작성하기가 어려운점이 있습니다. findByEmail, existsByEmail 같은 유니크한
빅데이터
중국의 가장 큰 온라인 지불 회사로 알려져 있는 알리페이의 데이터분석 조직의 Technical director의 발표를 들을 수 있는 모임이 있어 소개하려고 합니다. 작은 소모임이다 보니 특별한 홍보는 하지 않고 있는것 같은데 관심있으신 분이 있을 것 같아 공유 합니다. 다음은 관련 행사 내용 영문 버전 입니다. Invitation from CIO Salon Seoul (March
해당 코드는 Github를 확인해주세요. step-12: 페이징 API 만들기 에서 JPA와 Pageable를 이용해서 간단한 페이징 API를 만들었습니다. 이번 포스팅에서는 Query Dsl 동적 쿼리를 이용해서 검색 페이징 API를 만들어 보겠습니다. 기초 작업 Maven을 기준으로 설명드리겠습니다. 아래의 코드를 pom.xml에 추가하고 mvn compile을 진행합니다. <dependency> <groupId>com.querydsl&
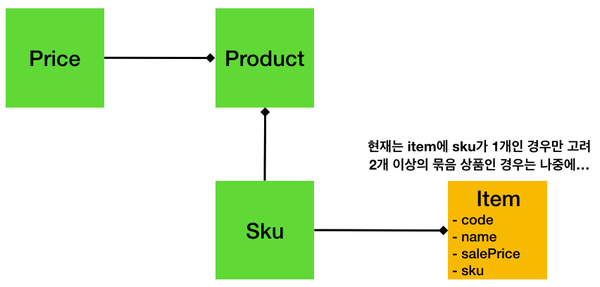
첫 연재에서 소개한 개념 정제 후에 동료 개발자가 해당 내용 구현에 나섰습니다. 두 계층으로 나누어 연결한 상품 개념 이전에 그린 그림을 조금 수정해서 상황에 대한 설명을 보강합니다. Product와 Item 개념 사이에 그린 두 가지 관계를 동료 개발자가 구현한 것이 아닙니다. 그래서, 둘 사이를 연결하는 Catalog 개념을 추가하여, 그의 구현을 Catalog
해당 코드는 Github를 확인해주세요. JPA를 이용해서 Paging API를 만들어 보도록 하겠습니다. 페이징 처리는 거의 모든 웹 개발에서 사용하고 있습니다. 그렇게 복잡하고 어려운 구현은 아니나 실제 쿼리로 작성할 때는 상당히 번거로운 작업이 됩니다. 또 데이터베이스마다 페이징 쿼리가 조금씩 다르다는 점도 복잡도를 높이는 요인 중 하나입니다. Spring Data JPA에서는 이러한 문제를 아주
필자는 도메인 주도 설계Domain-Driven Design(이하 DDD) 빌딩 블록Building blocks[1]으로 애플리케이션을 구현하면서 엔티티ENTITY[2] 마다 리파지토리REPOSITORY를 만드는 것을 자주 보았는데 자세히 살펴보면 여러 엔티티를 묶어서 하나처럼 사용하는 경우가 대부분이었다. DDD에서는 이러한 연관 객체의 묶음을 애그리게잇AGGREGATE이라고 정의하고 애그리게잇에 포함된 특정 엔티티를 루트Root 엔티티라고 부른다. 그리고 리파지토리를 만들 때
1편에 이어 2편을 올려봅니다. Latency에 대한 이해 1편에서 언급하였듯이 Latency가 높아지는 (길어지는) 이유는 전송단의 각 파이프 라인 단계별 변수들이 복합적으로 작용하기 때문에 실무에서는 정확한 원인과 해결책을 찾기는 매우 어렵다. 또한, 종단간 (End-to-End) latency를 기술적으로 측정하는 정량화된 방법도 아직은 없는 상태이다. 어떤 분들은 카메라 앞에서 손을 흔들고 시간을 측정하시는