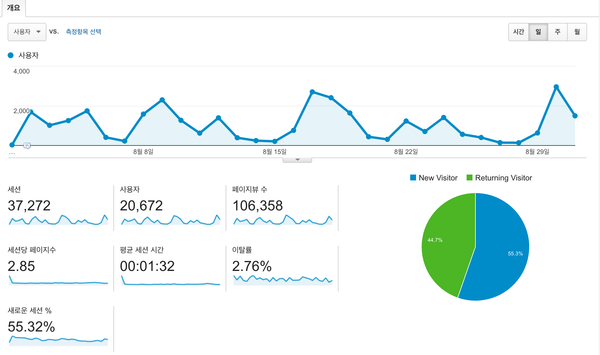
Popit 서비스 8월 운영 리포트
Popit 서비스는 오픈 소스 프로젝트 운영 개념을 서비스에 도입한 서비스입니다. 글 쓰기, 서비스 운영 등은 Contributor 들의 활동에 의해 운영되고 있으며, 서비스의 지표도 공개하고 있습니다. 월 1회 지표를 공개하고 있지만 8월에는 서비스 오픈 첫달이었기 때문에 중간에 지표를 한번 공개하였습니다. * 8월 운영 리포트(1) 위 글에서 Popit 서비스는 어떤 지표를 중점적으로
 Pop your eXperience. Share It.
Popit 서비스는 오픈 소스 프로젝트 운영 개념을 서비스에 도입한 서비스입니다. 글 쓰기, 서비스 운영 등은 Contributor 들의 활동에 의해 운영되고 있으며, 서비스의 지표도 공개하고 있습니다. 월 1회 지표를 공개하고 있지만 8월에는 서비스 오픈 첫달이었기 때문에 중간에 지표를 한번 공개하였습니다. * 8월 운영 리포트(1) 위 글에서 Popit 서비스는 어떤 지표를 중점적으로
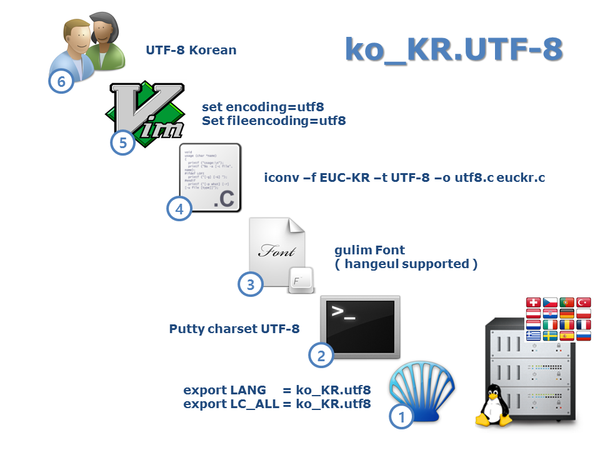
컴퓨터는 미국이 만들었다!! ASCII 는 쉽다!! 그러나, 우린 한국인이다!! ㅠㅠ 영어는 LTR 이다!! 한국어도 LTR 이다!! 그러나, 난 영어를 못한다!! ㅠㅠ 그런데, 나보고 RTL 을 지원하라고 한다?! ㅠㅠ http://en.wikipedia.org/wiki/Bi-directional_text 0. 글로발제이션!! 우리는 영어권이 아님에도 불구하고, 저를 포함해서 많은 개발분들이 i18n 이슈에 대해서 잘
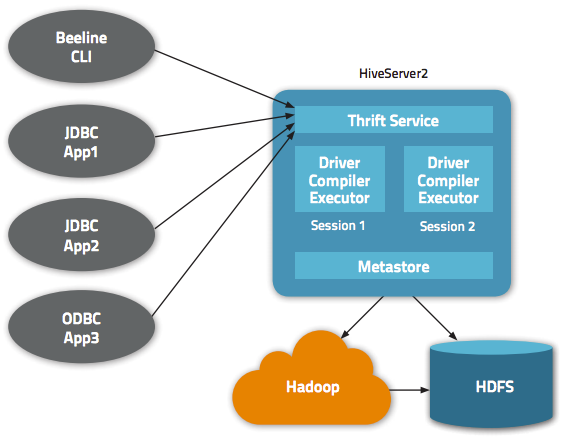
필요성 Hive Client 프로그래밍을 하다보면 Client 에서 실행한 Hive Query의 Job Id 값을 알아내야 하는 경우가 있습니다. 저의 경우에는 이전 글을 통해 공개되었던 Hadoop Data Warehouse 의 데이터 분석환경으로 Hive Query Language 를 수행할 수 있는 Zeppelin 과 매우 유사한 분석 툴을 직접 개발하여 사용하고 있는데, 이 툴에서 실행된 Job
MySQL, Apache, Tomcat 등과 같은 오픈 소스는 매뉴얼이나 문서, 책 등도 많이 나와 있으며 오픈 소스이지만 솔루션 자체도 안정적이라서 특별한 이유가 아니면 소스를 분석할 필요는 없습니다. 하지만 Hadoop이나 HBase 등과 같은 솔루션은 문서도 부족하지만 문서로만 설명할 수 없는 복잡한 내용으로 구성되어 있는 솔루션이 많습니다. 따라서 제대로 솔루션을 사용하거나 운영하기 위해서는
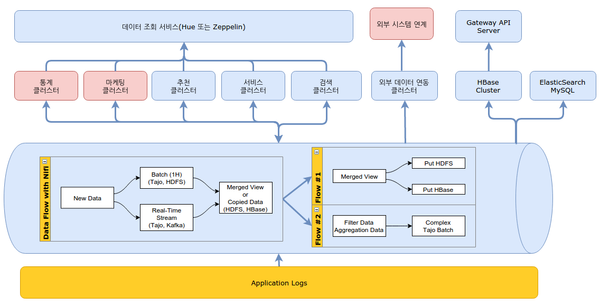
복잡해지는 빅데이터 클러스터 간에 데이터 동기화와 투명한 데이터 관리를 위한 고민을 공유하고, 이 문제를 해결하기 위한 오픈소스인 Apache NiFi를 소개하겠습니다. 연관 글: 멜론-빅데이터-이야기 소개 어떤 시스템이나 그렇듯 빅데이터 시스템도 여느 시스템과 같이 비즈니스 요건에 따라 점점 진화하게 되는데, 2011년 빅데이터로 불리는 하둡과 에코 시스템 모습과 현재의 빅데이터 시스템은
이 글은 highscability.com 에서 소개된 글에 대한 번역입니다. 원문을 최대한 전달하기 위해서 노력했습니다. ^^;; 원문은 다음에서 확인하실 수 있습니다. * 원문 : http://highscalability.com/blog/2016/8/15/how-paypal-scaled-to-billions-of-transactions-daily-using-ju.html PayPal 의 성과 최근에 PayPal 은 자신들이 운영하던 VM(Virtual Machine) 의
Intro 이 글에서는 Kubernetes 가 무엇인지 설명하고, 아키텍쳐와 구성요소에 대해 살펴봅니다. 그리고 minikube 를 이용해 로컬에서 Kubernetes 를 사용해 보겠습니다. 목차는 아래와 같습니다. * What is Kubernetes? * Kubernetes Architecture (abbreviated) * Getting Started with minikube * Kubernetes Object: Pod * Kubernetes Object: Service * Kubernetes Object: Deployment * Kubernetes Object: Pet Set * Kubernetes Object: Others * Summary
이 글은 Presto 관련해서 계속 연재되는 글 중 하나입니다. 이전글을 못보신 분들은 다음 글을 참고하세요. Presto SQL을 이용하여 Kafka topic 데이터 조회하기 Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(1) Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(2) 다 읽고 실망하실 분들을 위해 미리 밝히지만 이글은 실패한 삽질기
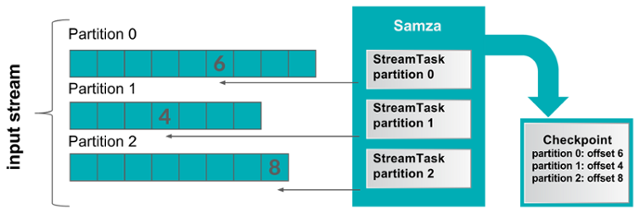
이전글 : 아파치-실시간-처리-프레임워크-비교분석 (1) 지난 글 에서는 아파치 프로젝트로 오픈되어 많은 인기를 얻고있는 Storm, Trident, Spark, Samza, Flink 에 대한 기본 특성과 분산 플랫폼의 필수 이론을 살펴보았습니다. 이번 글 에서는 무정지형(Fault Tolerance) 시스템구축, 상태관리, 성능 등의 좀더 깊이있는 주제와 더불어 실시간 스트리밍 처리 플랫폼에 대한 가이드라인
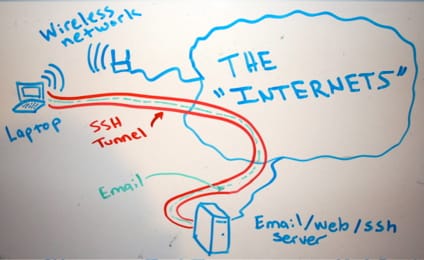
이번 글은 ssh 키 기반으로 인증하는 경우 기존의 authorized_keys 파일이 아닌 저장소 또는 방법으로 key 정보를 가져오는 방법에 대해 소개합니다. CentOS에서 테스트하였습니다. (이미지: https://www.engadget.com/2006/03/21/how-to-ssh-tunnels-for-secure-network-access/) ssh 키 기반으로 인증을 하게 되면 별도의 패스워드 없이 원격 명령을
Presto는 다양한 저장소를 지원하고 있는데 데이터 수집을 위해 Queue로 많이 사용되고 있는 Kafka도 기본적으로 제공하고 있습니다. 즉, Kafka의 topic에 저장된 데이터를 Presto SQL을 이용하여 조회할 수 있으며 Hadoop, S3, MySQL 등에 저장된 테이블과 Join 연산도 가능하다는 의미입니다. Presto와 Kafka를 연결하려는 이유는 저희 로그 데이터는 S3에 저장되는데 S3의 경우 Block Storage가
클라우드라는 단어를 사용한 개발자라면 오픈스택이라는 단어를 최소 한 번은 들어보셨을 겁니다. 오픈스택은 Rackspace와 NASA에서 시작한 IaaS(Infrastructure As A Service) 를 구축할 수 있는 Software로 글로벌 IT 업체의 대부분이 참여하고 있는 오픈소스 프로젝트로 IaaS라는 단어에서 알 수 있듯이 클라우드 인프라에 필요한 서버 가상화, 스토리지 가상화, 네트워크 가상화 기술들을 종합적으로 구현하였습니다.