bigdata

Time Series OLAP - Druid Trouble Shooting(6)

Time Series OLAP - Druid Trouble Shooting(6)

Druid - 오른손이 하는 일을 왼손이 모르게 하라 길고 길었던 Druid 시리즈 연재의 마무의리...이렇게 오래 걸릴줄은..... 그사이 Druid는 2018년 2월에 Apache Incubator Project가 되었다. 실시간 Index Task 1. tranquility를 사용해야 하냐?  supervisor(kafka-index-service)를 사용해야 하나? tranquility의 경우 실시간 데이터에 대한 push 방식, supervisor의 경우 input source로 부터
By jerryjung
[개요] 아파치 하둡 3.1.0

[개요] 아파치 하둡 3.1.0

여는 글 최근 아파치 하둡 3.1.0의 출시로 HDFS 의 Erasuere Coding 외에 분산 자원 관리자인 YARN에 특히 실용적인 기능들이 적용되었는데, 어떠한 기능들인지 차근차근 소개하겠습니다. 먼저, 공식 사이트에 게시 된 개요로부터 시작 하겠습니다. 개요 이 글에서는 주요 변경 사항에 대한 간략한 개요를 제공합니다. * YARN 기반에서 장기 실행 서비스들을 native와

By Jeon Deuk Jin
윈도우즈기반 도커에 Postgres-XL 설치하기

bigdata

윈도우즈기반 도커에 Postgres-XL 설치하기

빅데이터용 RDBMS가 필요해! 인터파크 사내에 추천시스템을 제공하기위해서 수많은 상품과 사용자 데이터를 마이닝하고 모델링을 거친 추천 상품들을 핸들링하기 위한 RDBMS가 필요했습니다. (그러나,,, RDBMS가 꼭 필요한 경우가 아니라면, 오픈소스 MPP 보단 가급적 Parquet 또는 다른 하둡 에코를 이용하시는게 정신건강에 이롭습니다.) 후보 솔루션 및 솔루션 선정 찾아본 솔루션은 다음과 같습니다. * Cockroach DB : Raft

By Jeon Deuk Jin
[후기글] DEVIEW 2017 DAY2

[후기글] DEVIEW 2017 DAY2

난생 처음 DEVIEW에 가보다 매년 DEVIEW 시즌이면 항상 이래저래 일이 생기거나 신청이 늦어 10년동안 한차례도 참석해 본적이 없었다. DEVIEW는 네이버가 주관하는 국내 최대 개발자 컨퍼런스 행사로 올해로 10주년을 맞았다. DAY1은 아쉽게 놓쳤지만 DAY2에 참석한 소감과 발표된 내용에 대한 간단 리뷰를 작성해 보려고 한다. 세션은 주관적인 취향에 의해 선택된 것이므로 몸이

By jerryjung

kubernetes 어디까지 써봤니? 삽질기(1)

Kubernetes 삽질의 시작 이 글은 kubernetes관련 삽질기로 시리즈로 연재될 예정이다. kubernetes에 대한 소개는 이전글을 참조하기 바란다. kubernetest(이하 k8s)는 오픈소스 컨테이너 관리 툴이다. k8s는 Go언어로 개발되어 있으며 경량의 이식 가능한 어플리케이션이다. k8s를 Linux기반의 OS에 올려 다수의 호스트에 클러스터 풀을 생성한후 docker컨테이너 어플리케이션을 올리고 관리하고 확장 가능하게 설정할 수 있다.

By jerryjung
빅데이터 시대, BI Solution (Spotfire) 활용법

빅데이터 시대, BI Solution (Spotfire) 활용법

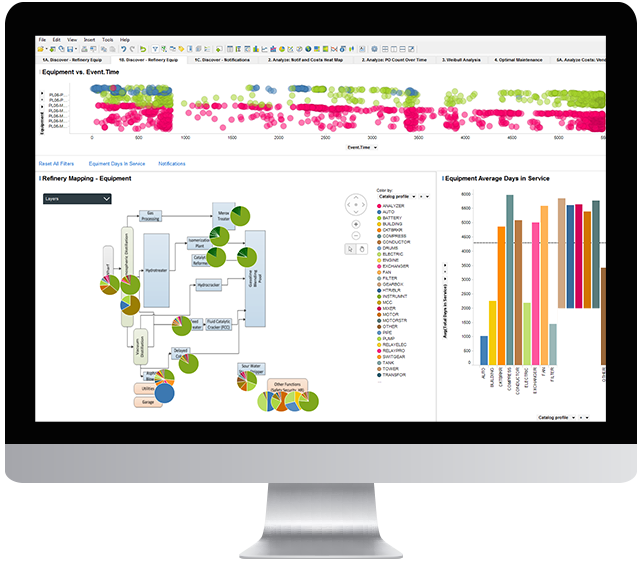
이번 글 에서는 대표적인 Business Intelligence(이하 BI) 솔루션 중 하나인 Spotfire 의 기능과 특성에 대해 살펴보고, 빅데이터 시대를 살아가며 효율적으로 BI 솔루션을 활용할 수 있는 분야와 방법에 대해 살펴보고자 합니다. 단, 솔루션 Provider 입장에서의 제품 홍보성 기능 설명이 아닌, 사용자 입장에서 경험했던 장점과 단점을 바탕으로 BI 솔루션의 적절한 적용

By 홍 태희
NSA의 Dataflow 엔진 Apache NiFi 소개와 설치

NSA의 Dataflow 엔진 Apache NiFi 소개와 설치

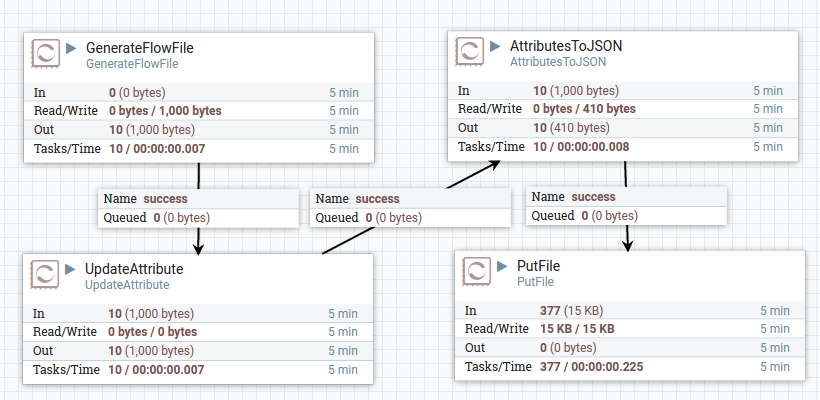
Apache NiFi는 NSA(National Security Agency)에서 Apache에 기증한 Dataflow 엔진입니다. 복잡해지는 기업의 시스템들에서 신속하고, 유실 없는 데이터 전송은 점점 더 중요해 지고 있습니다. 빅데이터 시스템도 마찬가지로 데이터의 전송 경로가 더 복잡해지고, 실시간 처리가 중요해지는 시점에 Apache NiFi는 훌륭한 솔루션입니다. 여기서는 NiFi의 소개와 설치에 대해서 알아보도록 하겠습니다. 본 글은 저자가

By 병화 윤
우버 (Uber), 도대체 무엇이 특별할까? - 우버 분석

우버 (Uber), 도대체 무엇이 특별할까? - 우버 분석

우버 (Uber) 의 데이터를 활용한 특장점 공유경제의 대표적인 기업 '우버 (Uber)', 그리고 데이터 분석에 대해 간략하게 알아보도록 하겠습니다. 공유경제 (Sharing Economy)는 기존의 소비 패턴을 완전히 바꾸고 있으며 기존 물건을 구매하여 소유하는 '소유 경제'에서 불필요한 소비자원의 낭비를 줄이고 사회 공동의 이익이 기여한다는 점에서 매우 긍정적인

By rianchoi
NiFi를 이용한 빅데이터 플랫폼 개선

NiFi를 이용한 빅데이터 플랫폼 개선

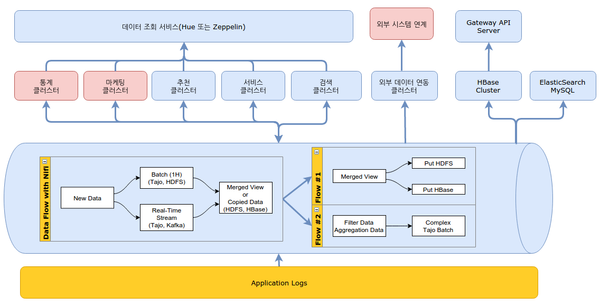
복잡해지는 빅데이터 클러스터 간에 데이터 동기화와 투명한 데이터 관리를 위한 고민을 공유하고, 이 문제를 해결하기 위한 오픈소스인 Apache NiFi를 소개하겠습니다. 연관 글: 멜론-빅데이터-이야기 소개 어떤 시스템이나 그렇듯 빅데이터 시스템도 여느 시스템과 같이 비즈니스 요건에 따라 점점 진화하게 되는데, 2011년 빅데이터로 불리는 하둡과 에코 시스템 모습과 현재의 빅데이터 시스템은

By 병화 윤
멜론 빅데이터 이야기

멜론 빅데이터 이야기

멜론의 빅데이터 도입 시 고려했던 점과 시스템을 소개하는 글로 데이터를 수집, 분석 그리고 결과를 서비스하기까지의 과정에서 사용되는 오픈 소스도 소개합니다. 조금이나마 빅데이터 시스템 도입 시, 도움이 되었으면 좋겠습니다. 소개 2011년 10월 가을, 멜론은 MLCP(Music Life Connected Platform) 프로젝트를 시작했습니다. 프로젝트 핵심은 사용자의 10년간의 소비 이력을 분석하여 아티스트와 기획사 등의

By 병화 윤
Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(1)

Presto, Zeppelin을 이용한 초간단 BI 시스템 구축 사례(1)

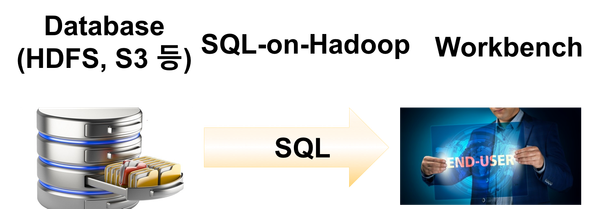
최근 데이터 저장, 처리 관련 다양한 솔루션과 오픈 소스가 나타나면서 다양한 모습으로 데이터 처리 시스템을 구축할 수 있게 되었다. 이번 글에서는 6개월 정도 작업을 통해 현재 운영 중인 서비스에 적용한 Presto, Zeppelin를 이용하여 간단한 BI 체계를 구축했던 경험에 대해 공유하고자 한다. 이 글은 두 개의 글로 구성되어 있으며 첫 번째

By 김형준